NCCLX:把通信从 GPU 里“搬”出来
Meta 如何用 Host-driven、Zero-copy 与端网协同,在大规模 RoCE 网络上重新设计集合通信。
论文:Collective Communication for 100k+ GPUs (NCCLX),Meta,arXiv:2510.20171v4(2026.01) 解读视角:RDMA / AI Infra / 高性能网络一线工程视角,观点与事实分离,原图优先。
TL;DR(先给结论)
- NCCLX 不是“更快的 NCCL”,而是一个插在 PyTorch 与 NIC 之间的“通信操作系统”。 它用 Host-driven 的 CTran 框架把协议控制从 CUDA kernel 卸载到 CPU,用 Zero-copy / SM-free 数据面把单卡 HBM 占用从约 10 GB 砍到约 4.2 GB,最终让 Llama4 训练稳态步延迟降低 12%、96K 规模初始化提速 11×。
- 网络层真正的“护城河”是 DQPLB(Dynamic Queue Pair Load Balancing)。 它按“同机架 / 跨机架同区 / 跨区同 DC / 跨 DC”四类距离,动态限制 data QP 数、单 QP 未完成消息数、最大 segment 大小,把交换机缓冲堆积压低一个数量级——本质上是在软件里重做了一次 RDMA 的 credit 流控。
- 训练侧三板斧:PP 用 zero-copy SM-free Send/Recv;TP 用 RMA Put(MPI-2 one-sided 语义)+ Tree-pipeline overlap,E2E 降低 1.57×;HSDP 用 FTAR Ring AllReduce,半量 SM 即可追平 NCCL、等量 SM 低 9%–18%。
- 推理侧双引擎:GPU-resident 元数据让 AllToAllvDynamic 绕开 CUDA graph 的 padding 诅咒,端到端解码延迟提升 15%–80%;Low-latency 优化(small-message fast path、双缓冲、WR chaining)把控制开销打穿。 在 MoE 推理这种 AllToAll 主导的场景里,收益是结构性的。
- 适用边界极清晰:硬件强依赖 NVIDIA H100 + RoCE/IB RDMA NIC,软件需要 PyTorch 深度集成与可扩展内存池,收益随拓扑异质化(跨楼、跨区、跨 DC)而被放大。 小规模同构集群、非 NVIDIA 生态、CPU 调度主导的负载,几乎拿不到 NCCLX 的核心红利。
1. 引言:为什么“更快的 NCCL”是个伪命题?
很多人初读这篇论文会把它当成“Meta 又给 NCCL 打了个补丁”。这是最大的误读。
NCCL(NVIDIA Collective Communications Library)自 2016 年随 Pascal 时代发布以来,长期是 GPU 集合通信的“事实标准”——PyTorch DDP/FSDP、DeepSpeed、Megatron、vLLM 全都跑在它上面。它的设计哲学是**“通用最大公约数”**:一套实现,自动探测 NVLink/NVSwitch/PCIe/IB/RoCE 拓扑,对 ring、tree、NVLS 等算法按集合类型、消息大小、集群形状择优选路。这套哲学在“单机八卡”“同机房数千卡”的时代非常成功。
但到了 100k+ GPU、跨五栋楼、三层 Clos、延迟跨度 1× 到 30× 的 Llama4 集群,NCCL 不是“慢”,而是**“假装通用”导致的结构性失配**。论文在引言里就点明了基线 NCCL 的执行模型假设:
“NCCL employs a host-initiated communication model, where the CPU schedules communication and defines input arguments as CPU variables. … NCCL’s execution model is designed for regular collective patterns where communication arguments (e.g., size, data type) can be statically expressed as host arguments.”
这话表面上是说 NCCL 的优势,实际上也划出了它的天花板:当通信参数需要动态表达、当 GPU 必须常驻元数据以支持 CUDA graph 推理、当网络和硬件故障成为常态时,host-initiated + 静态参数的模型就不够用了。 NCCLX 的全部设计,都是对着这三条天花板去的。
本文的路线图:先解剖 Meta 的网络拓扑(这是 NCCLX 的物理前提),再拆解 CTran 协议栈这一“元创新”,然后逐层看 Zero-copy、DQPLB、训练/推理定制、初始化与工具链,最后用组织归因(康威定律)和适用边界收口。所有高价值原图全部嵌入,关键设计逐图解读。
关键词:Host-driven、Zero-copy、SM-free、CTran、DQPLB、GPU-resident metadata、FTAR(Fault Tolerant AllReduce)、HSDP、multi-building RoCE fabric、CUDA graph、端网协同流控。
2. 网络拓扑:Meta 的“多楼宇 RoCE 丛林”是 NCCLX 的物理前提
任何通信库的优化,都必须先问一句:它在什么网络上跑? NCCLX 的答案是一个绝大多数公司都复制不了的网络。
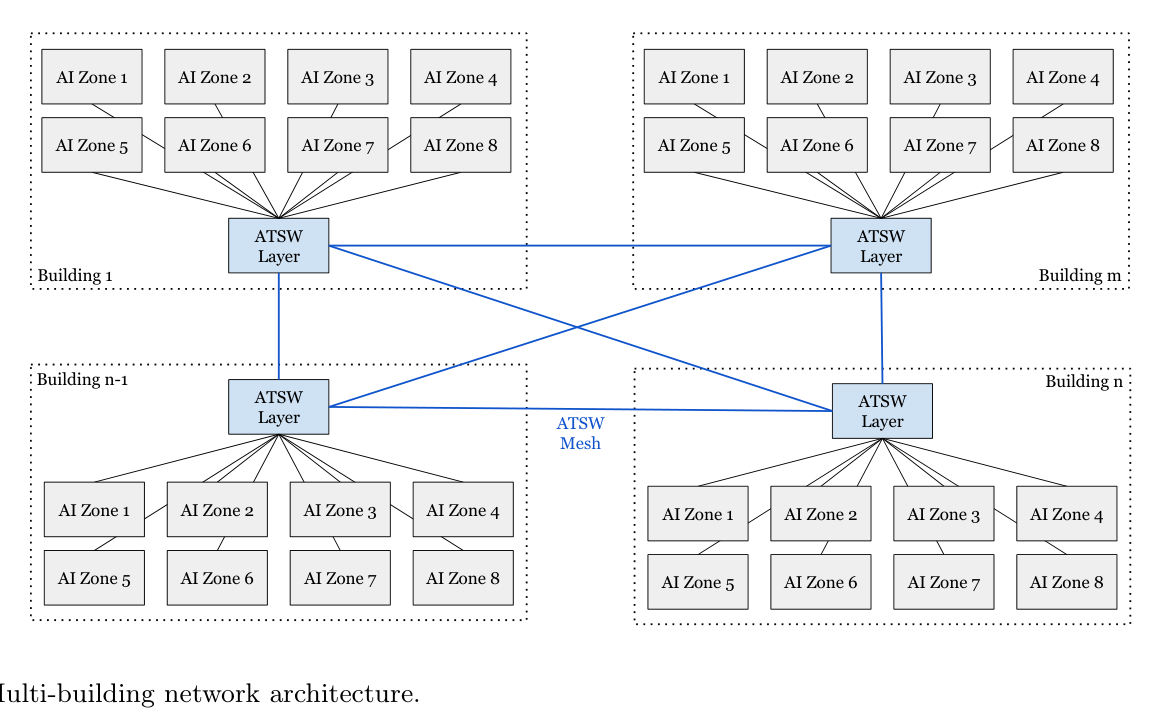
图 1:Llama4 的多楼宇网络架构。RTSW(机架交换机)上联 CTSW(AI Zone 内 Spine),CTSW 再上联 ATSW(聚合训练交换机,跨楼宇 Super-Spine)。同序号 ATSW 跨楼 Full Mesh,构成 76 个正交平面。
Meta 为 Llama4 部署的是 Type 1 Region、五栋楼、20 个 data hall、38 个 AI Zone、超过 10 万张 H100。物理拓扑是三层 Clos:
- RTSW(Rack Top Switch / Leaf):机架内 8×400G Scale-Up 连接,服务张量并行(TP)的极致带宽需求;
- CTSW(Cluster Top Switch / Spine):AI Zone 内部 Scale-Out,承载同 Zone 内通信;
- ATSW(Aggregation Training Switch / Super-Spine):连接各楼的 CTSW,把 RoCE 的应用范围从单个 AI Zone 扩展到整个 Region,用 Full Mesh 互联同序号 ATSW,切出 76 个物理隔离的正交平面(每个平面故障仅导致 1/76 ≈ 1.3% 带宽线性降级)。
最关键的不是拓扑形状,而是延迟与带宽的层次化异质性:
| 连接层级 | 相对延迟 | 带宽收敛比 | 主要服务并行维度 |
|---|---|---|---|
| 同机架(intra-rack) | 1× | 1:1 | TP / NVLink 域 |
| 跨机架同区(cross-rack) | 7× | 1:1 | TP / PP |
| 跨 AI Zone 同 DC | 15× | 1:2.8 | DP / EP |
| 跨 DC | 30× | 1:2.8 | DP(异步、弹性) |
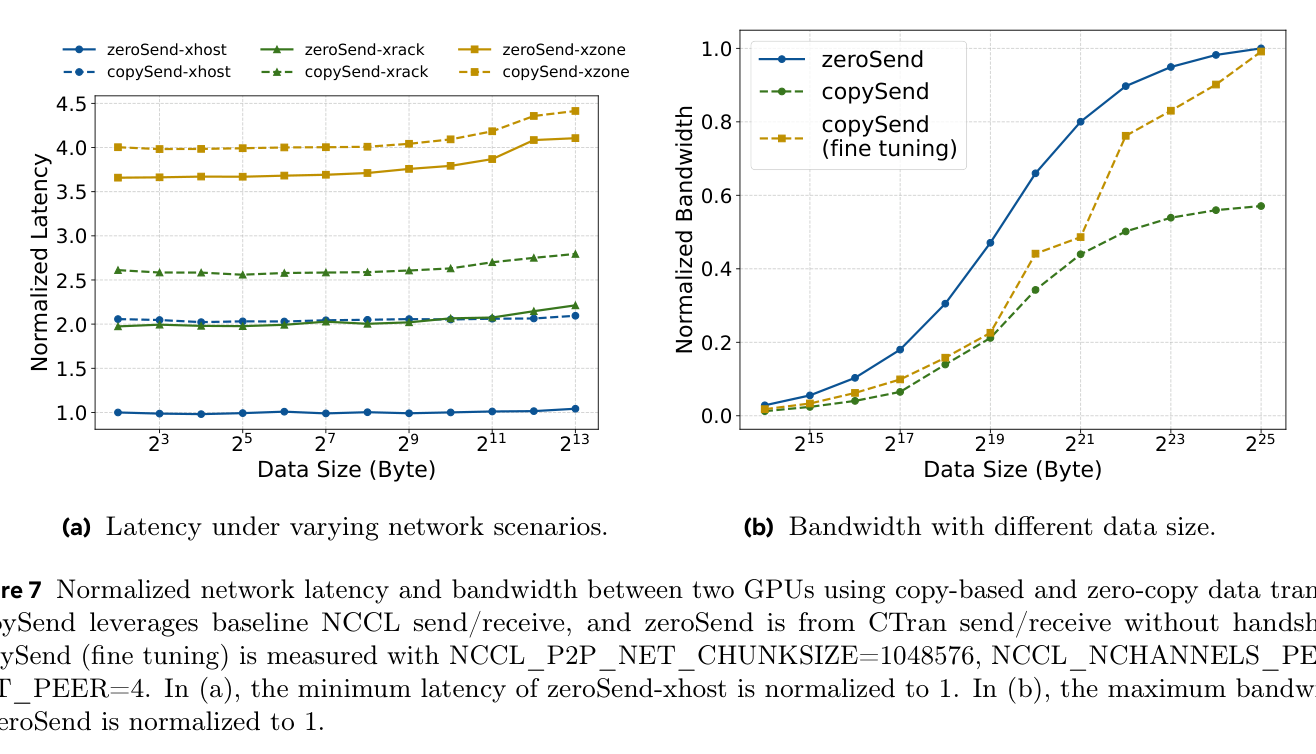
图 7:不同层级连接的延迟与带宽对比。红线是“跨 DC / 跨 Zone”的长尾延迟,正是 NCCLX 必须显式建模的对象。
工程取舍点:楼内网络保持 1:1 无阻塞(因为 TP 对带宽极度饥渴),跨楼方向收敛比从 Llama3 的 1:7 收紧到 1:2.8——这是在对“光纤/相干光模块成本”与“训练效率”之间反复权衡后的结果。换句话说,这个网络不是通用数据中心网络,而是为 Llama4 的并行策略(TP 留楼内、DP/EP 放跨楼)反向定制出来的。
观点:理解 NCCLX 的第一步,是承认它“生来就绑定 Meta 的 RoCE 丛林”。脱离了这种层次化、长尾延迟、跨楼光纤的物理前提,论文里一半的优化(尤其是 DQPLB 的分层参数)会失去意义。
3. CTran 协议栈:Host-driven 是架构级别的“元创新”
NCCLX 在 PyTorch 之下统一管理训练与推理的全部通信,其底层传输引擎叫 CTran(Custom Transport)。CTran 最大的范式转换,是把集合通信的控制平面从 CUDA kernel 里彻底搬出来,交给 CPU 线程驱动。
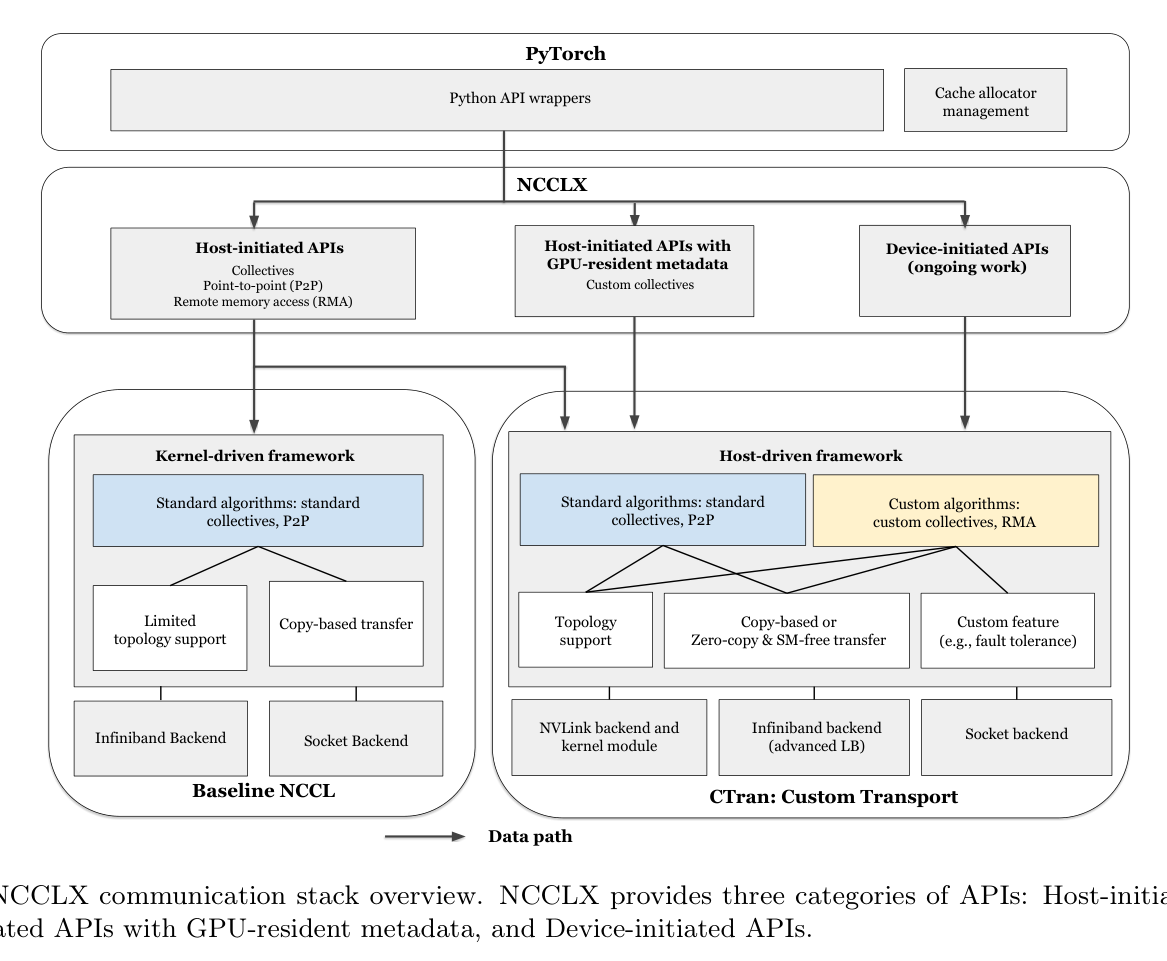
图 2:NCCLX 相对 baseline NCCL 的协议栈变化。控制逻辑(协议处理、同步、重传)从 GPU kernel 下沉到 host CPU,数据面走 zero-copy RDMA / NVLink。
论文自己用一张表(Table 1)把 NCCLX 的全部关键特性与目标工作负载/问题一一对应,这是通读全文前的“总地图”:
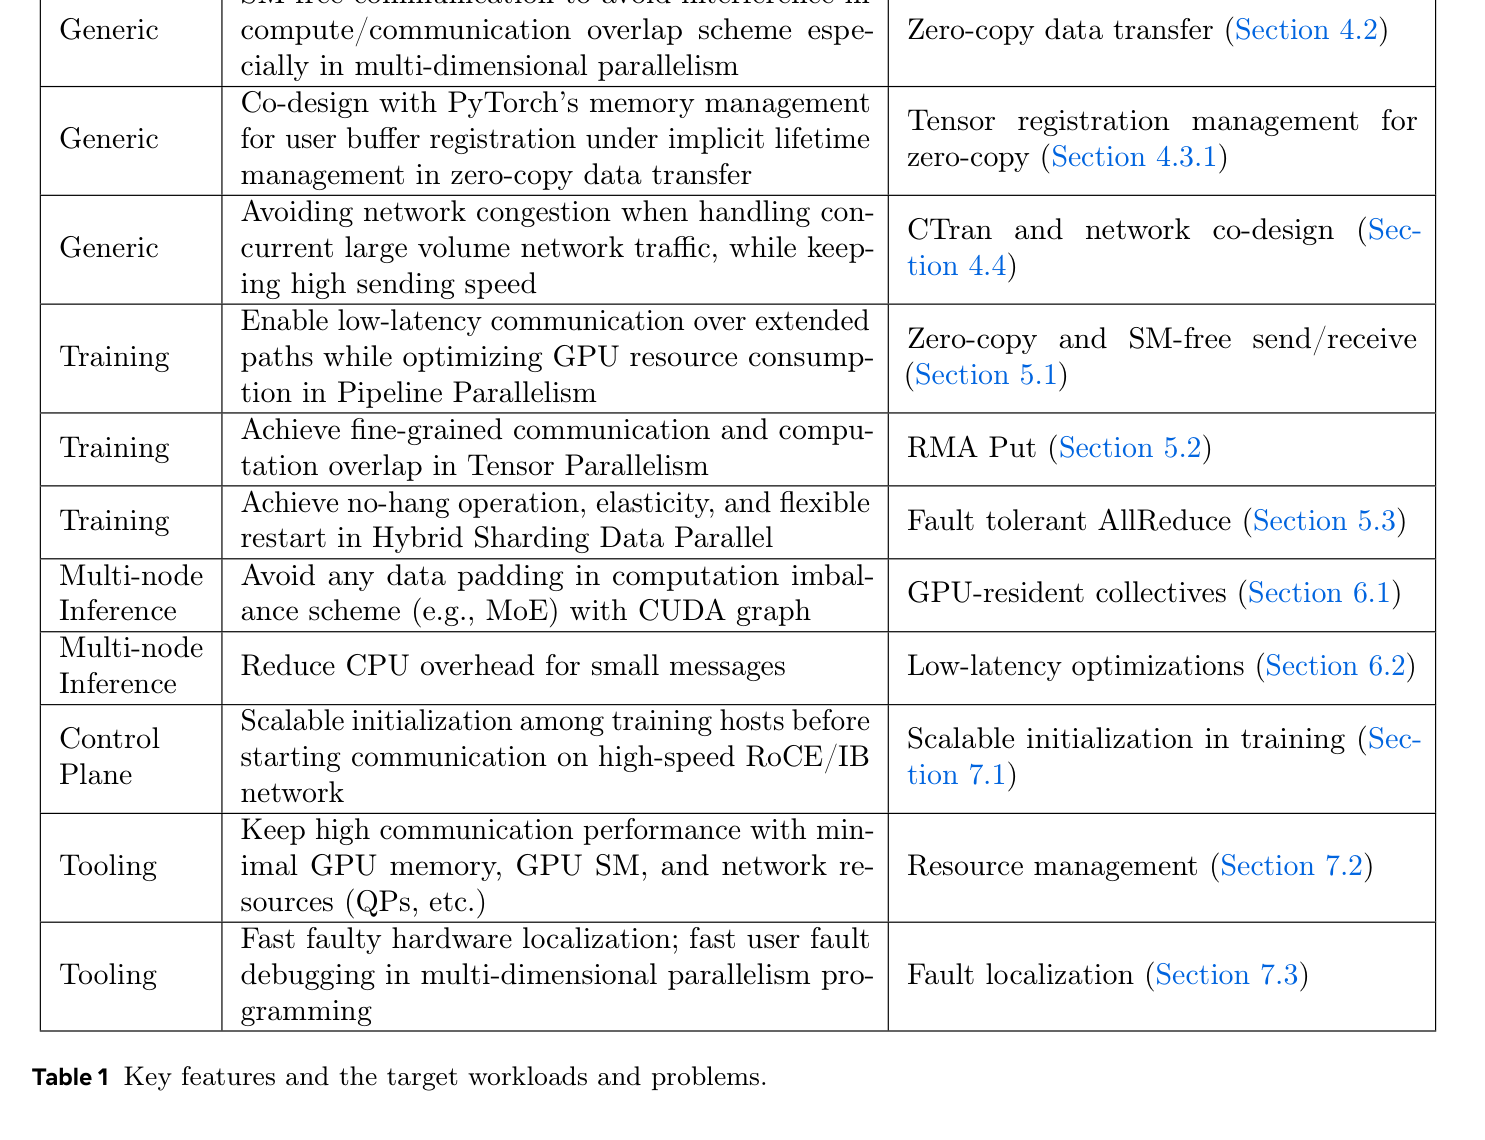
表 1:NCCLX 关键特性及其对应的目标工作负载与问题。Host-driven、Zero-copy、DQPLB、GPU-resident、FTAR 等支柱在这一张表里被一次性定位。
NCCLX 定义了三类执行模式,体现其演进路线:
- Host-initiated APIs:CPU 调度通信、定义参数(这套最接近原 NCCL);
- Host-initiated APIs with GPU-resident metadata:通信元数据常驻 GPU、以引用方式传递——这是推理优化的关键(第 7 节);
- Device-initiated APIs:由 GPU kernel 直接发起通信(论文标注为进行中,是下一步方向)。
控制面如何不下放还保证协同?论文用一张图讲清楚了 CPU 线程与 CUDA kernel 的分工:
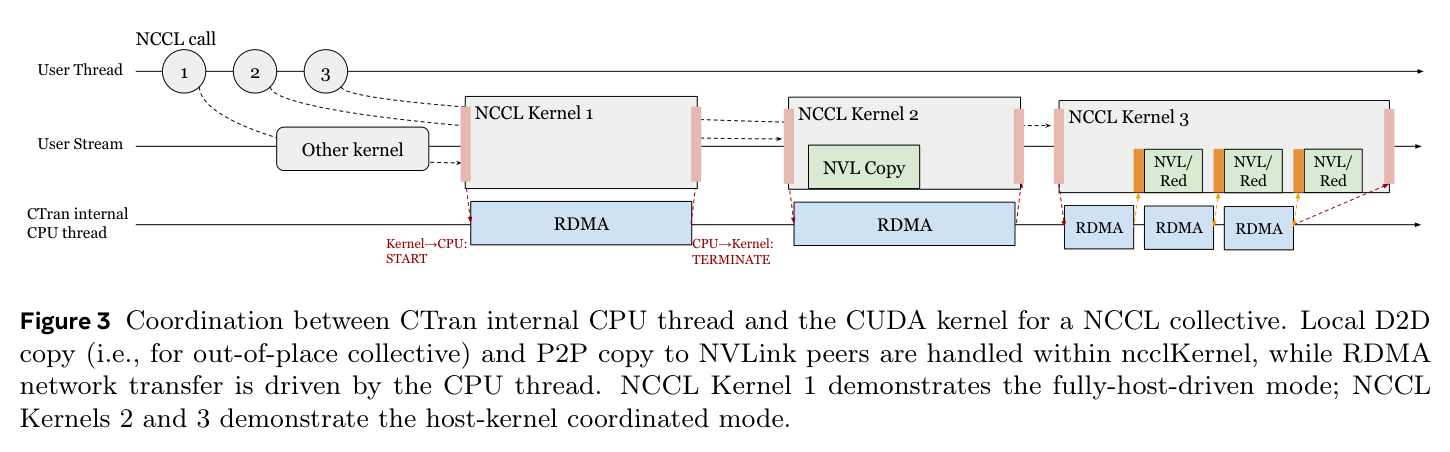
图 3:CTran 内部 CPU 线程与 CUDA kernel 的协同。本地 NVLink 拷贝由 kernel 轻量触发,跨节点 RDMA 由 CPU 线程直接驱动,二者通过 host pinned memory 的轻量标志位精细化协同,同步开销 < 1μs。
为什么这是“元创新”而非“小优化”:原 NCCL 在 kernel 里跑集合算法,意味着通信一启动就占用 SM(流式多处理器),与计算争抢资源;而且每次集体都要 kernel launch + 在 GPU 上做协议处理。CTran 把协议处理、同步协调、重传逻辑全搬到 CPU,GPU 只做“触发”和“计算”,于是通信与计算第一次在资源层彻底解耦。
观点:Host-driven 的代价是把 CPU 推上了通信关键路径。论文说同步开销 < 1μs,但这是“协同标志”的开销,不是“CPU 调度所有集合”的总开销。在 10 万卡规模下,CPU 核心数、NUMA 亲和性、线程调度抖动会成新的瓶颈——这是 NCCLX 没有明说、但后续必然要还的债。这也解释了论文为什么把第 9 节(Fault Analyzer / CollTrace / Profiler)当作一等公民:当控制面在 CPU,可观测性就必须跟得上。
论文在 Related Work 里把 NCCLX 与 NVSHMEM、MSCCL、ACCL、Gloo 等并列,但本质上它的位置更靠近 “用户态 RDMA 通信框架 + 集合算法引擎” 的合体,而非单纯集合库。
4. Zero-copy 与 Tensor Registration:砍掉“拷贝税”
传统 NCCL 的 copy-based 通信路径是:用户发送缓冲区 →(D2D 拷贝)→ FIFO 暂存缓冲区 → PCIe → NIC → 网络 → NIC → PCIe → FIFO →(D2D 拷贝)→ 接收缓冲区。中间那两次 D2D 拷贝不仅吃带宽,更吃宝贵的 SM。
NCCLX 的 zero-copy 路径是:用户缓冲区 → PCIe → NIC → 网络 → NIC → PCIe → 用户缓冲区。NIC 直接对用户缓冲做 RDMA,中间 FIFO 消失。
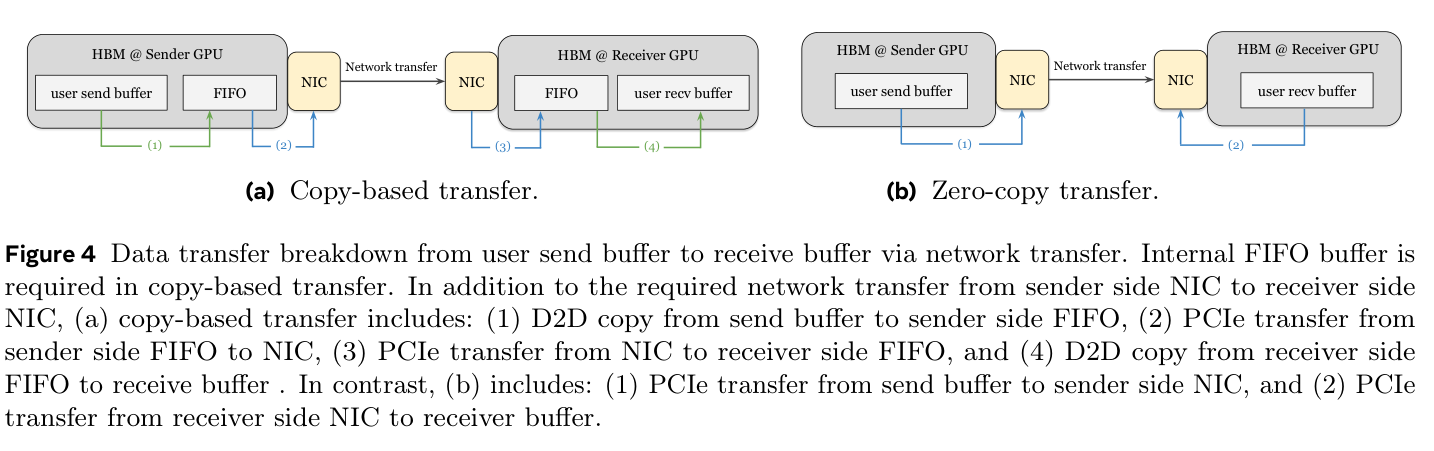
图 4:左为 copy-based(多跳 D2D + FIFO 暂存),右为 zero-copy(NIC 直连用户缓冲)。
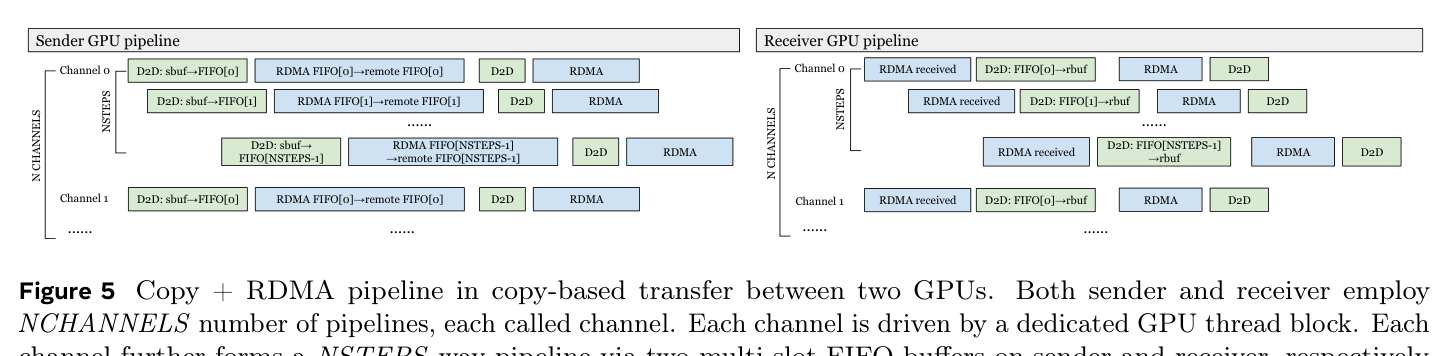
图 5:copy-based 路径把数据搬运与 RDMA 串行化,zero-copy 让 NIC 直接进出用户缓冲,省掉 staging。
但 zero-copy 有个前置条件:tensor 必须提前注册到 RDMA(pin-down + 地址登记)。论文坦白了一个现实痛点——注册时延会偶发飙升到 100ms:
“However, during GPU buffer registration in real-world scenarios, we’ve observed significant registration time spikes, occasionally extending to 100 milliseconds. Our investigation points to inter-process lock contention within the GPU RDMA driver as a primary cause.”
这其实是 NVIDIA GPU RDMA 驱动层面的锁竞争,连 Meta 都要“currently collaborating with NVIDIA to identify the root cause”。这恰恰说明 NCCLX 的 zero-copy 不是单点算法胜利,而是把问题暴露给了全栈协同。
为此 Meta 扩展了 PyTorch 的 CUDA Cache Allocator(CCA),提供两种注册模式:
- auto-registration(lazy registration):扩展
ncclCommRegister,实际网络注册推迟到 tensor 首次被用于集合通信时才发生(“lazy”); - memory-pool 模式:配合 CCA 的 expandable segment,复用已注册地址区间。
但这里论文又自曝了一个软肋:
“We note that, however, we cannot enable NCCL zero-copy in our production workloads due to the suboptimal buffer registration support especially when using with the expandable segment mode of Pytorch cache allocator.”
原文品读:这话很客气,但分量很重。它等于承认:零拷贝在生产负载里是“受限开启”的,根因是 PyTorch CCA 的 expandable segment 与 RDMA 注册不兼容。 换句话说,zero-copy 的红利不是“开箱即得”,而是绑定在一整套内存池改造之上。这也是为什么本文反复强调:NCCLX 的红利强依赖 PyTorch 深度集成——它把通信库的边界,推进到了框架的内存分配器内部。
量化收益方面,论文用 Table 4 给出了 Llama4 预训练(64K GPU)逐项内存节省:
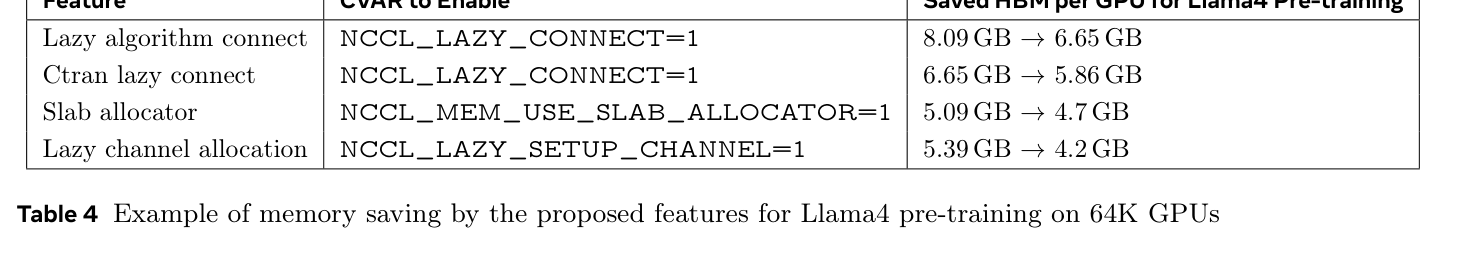
表 4:Llama4 64K GPU 预训练下,NCCLX 各项特性带来的单卡 HBM 节省。结合正文,单卡 HBM 占用从 ~10 GB 降到 ~4.2 GB(降幅约 58%)。
5. DQPLB:端网协同的“分层流控”
Zero-copy 省掉了中间缓冲,但也削弱了对接收端反馈的机会——数据包一旦交给 NIC,就完全依赖网络硬件做流控。论文自己把这个矛盾讲得很直白:
“One drawback of the zero-copy communication is that the entire message is handed off to the network hardware at once, relying solely on the network fabric for both flow control and congestion control. … zero-copy communication reduces opportunities for receiver feedback, increasing the likelihood of posting larger messages at once, which potentially leads to network overwhelming and excessive buffer build-up.”
原文品读:这是论文里最诚实的一段工程自省。它承认 zero-copy 单独用会“翻车”(switch buffer build-up 恶化),然后引出 DQPLB 作为补丁。本质问题是:zero-copy 把流控责任从“库内分段”甩给了“网络硬件”,而 RoCE 网络(不像 IB 有硬件 credit)恰恰最缺这一层。 Meta 的解法是:在库内把数据重新分段、对在途 segment 数量做速率限制,并按拓扑分层配置。
DQPLB 的核心设计:每个连接 = 1 个 control QP + 多个 data QP。然后按连接类型分类限制:
| 连接类型 | data QP 数 | 单 QP 未完成消息数 | 最大 segment 大小 | 设计意图 |
|---|---|---|---|---|
| 同机架(intra-rack) | 保守(少) | 保守 | 小 | BDP 小,激进反而 incast |
| 跨机架同区(cross-rack) | 中 | 中 | 中 | — |
| 跨区同 DC(cross-AI-Zone) | 较多 | 较多 | 较大 | BDP 增大 |
| 跨 DC | 激进(多) | 激进 | 大 | BDP 大,要喂满长肥管道 |
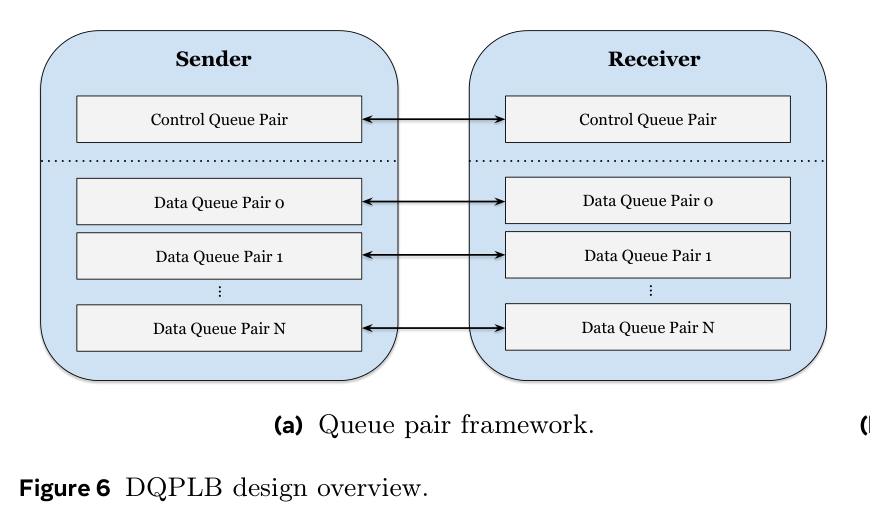
图 6:DQPLB 的 QP 结构与分层参数。左为单 control QP + 多 data QP 的拓扑,右为按距离分层的在途字节上限配置。
编码技巧:DQPLB 用 IBV_WR_RDMA_WRITE_WITH_IMM 的 32-bit immediate 字段承载控制信息——bit 0–23 为消息序号,bit 30 标记 fast path,bit 31 标记通知标志。接收端用一张哈希表做乱序(OOO)跟踪,配合滑动窗口保序。这套机制让 zero-copy 的 RDMA WRITE 也能在软件层恢复“接收端驱动流控”的语义。
量化收益:
- P2P 延迟/带宽在中消息区间取得 1.09×–2.7× 提升(Fig.10);
- 与 deep-buffer 交换机、VOQ 调优叠加后,交换机缓冲堆积相比 Llama3 训练降低一个数量级。
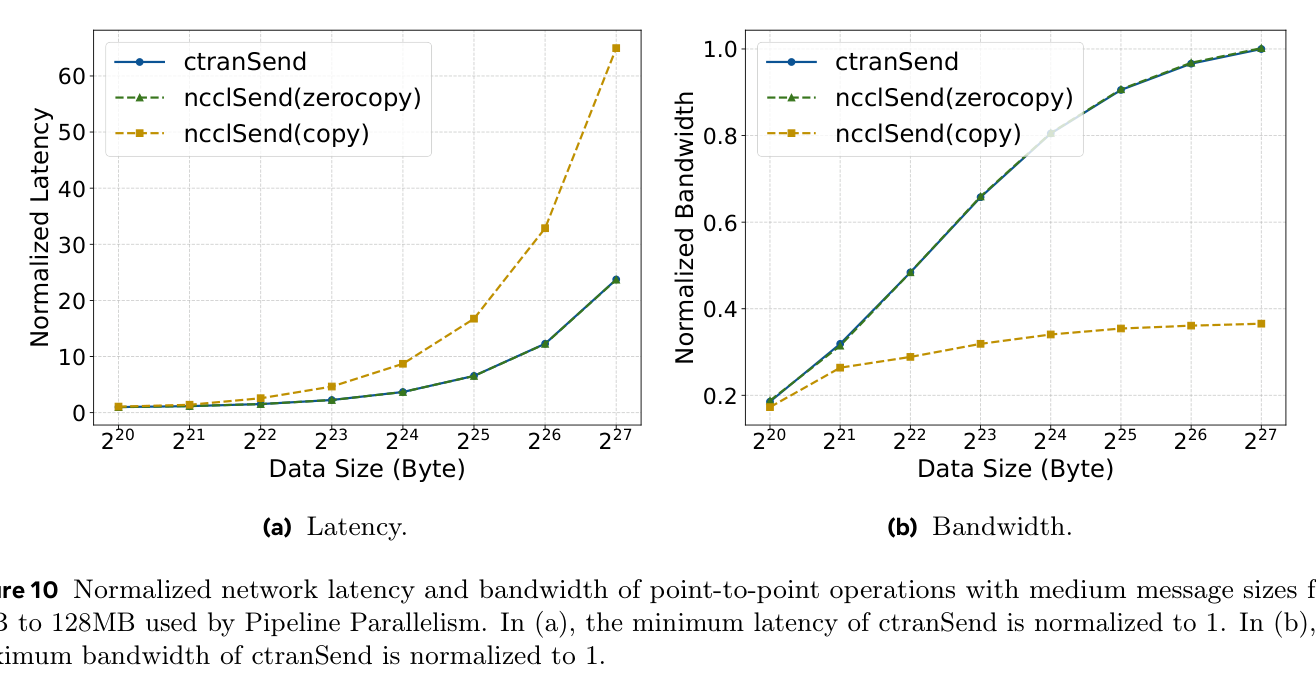
图 10:CTran zero-copy 的 P2P 延迟(a)与带宽(b),相对 NCCL copy-based 取得 1.09×–2.7× 提升。
观点:DQPLB 是整篇论文里“端网协同”思想最集中的体现。它不妨被看作 “在 RoCE 上用软件重建 IB 的 credit 流控”。对用 IB 的团队,这层可能冗余;但对用 RoCE(国内绝大多数智算中心)的团队,这是可直接借鉴的范式——而且它不依赖任何交换机硬件特性,纯软件即可落地。
6. 训练场景定制:PP / TP / HSDP
NCCLX 不是“一个通用集合库 + 全套算法”,而是针对 Llama4 的 PP/TP/HSDP 三种并行,分别做了定制化集合。
6.1 流水线并行(PP):zero-copy SM-free Send/Recv
PP 的点对点 Send/Recv 直接吃 CTran 的 zero-copy + SM-free 能力——本地 NVLink 拷贝由 kernel 轻量触发、跨节点 RDMA 由 CPU 驱动,完全不占 SM,通信与计算彻底解耦。
6.2 张量并行(TP):RMA Put + Tree-pipeline overlap
TP 的难点在于“通信和计算要重叠”。NCCLX 引入 CtranWindow + Put API,语义上对应 MPI-2 的 one-sided RMA(Remote Memory Access)——发起方直接 PUT 到目标窗口,无需目标侧显式 RECV 配合。
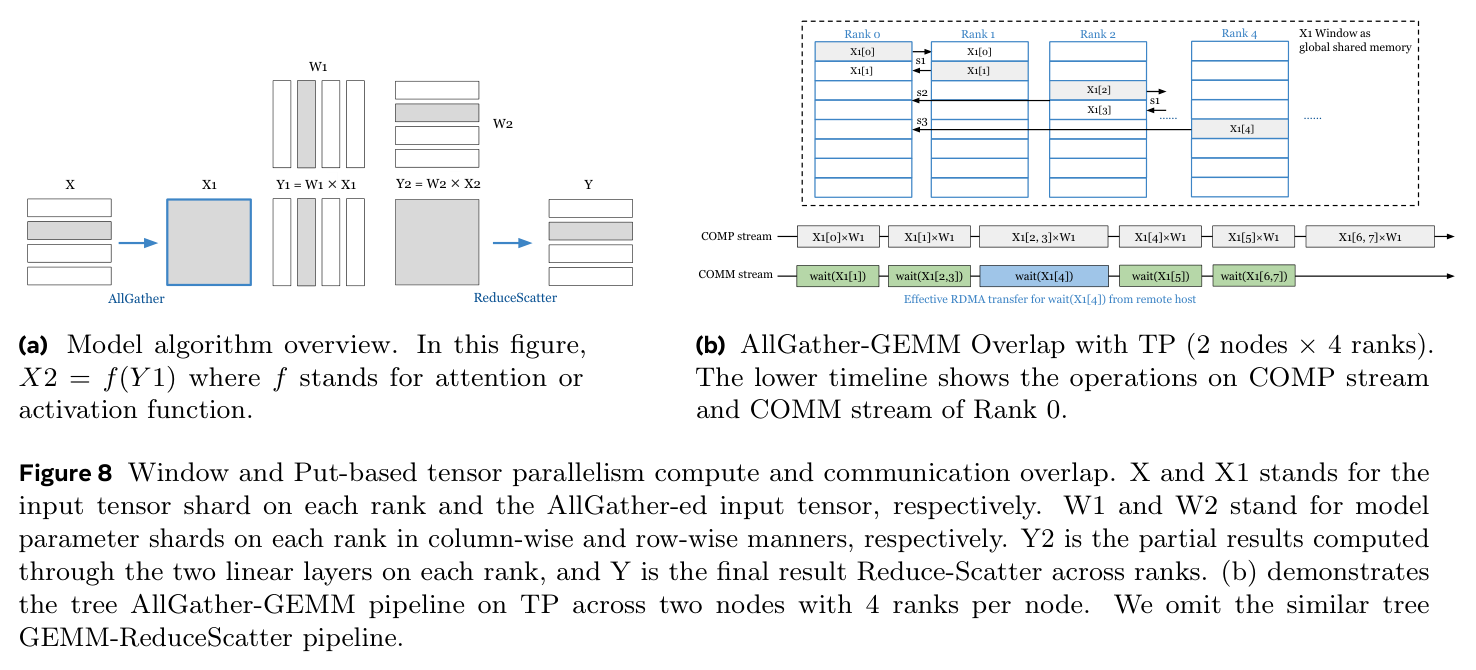
图 8:左为 CtranWindow 的 Put 语义(one-sided),右为把通信按 tree 流水线切分、与 GEMM 计算重叠。
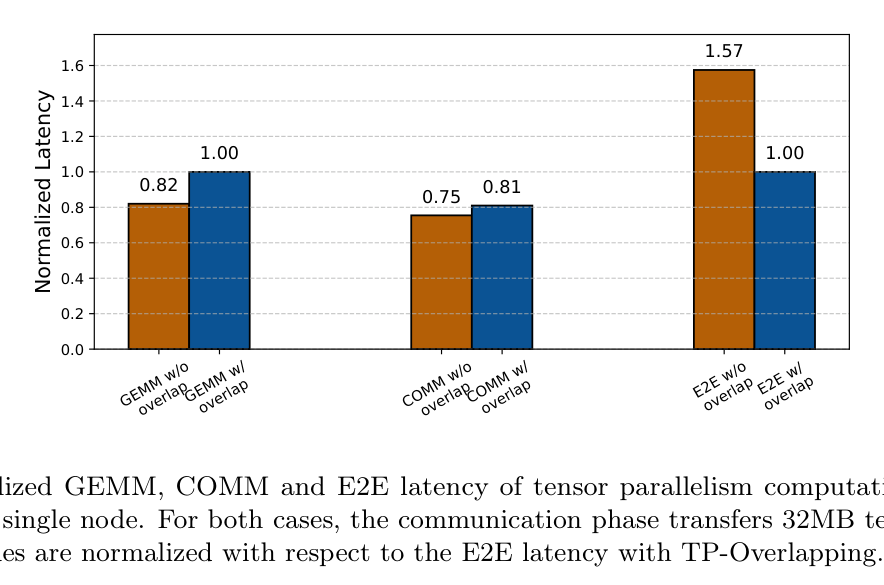
图 11:单节点 TP 负载下,开启 TP-Overlapping 后 E2E 时间降低(计算有极轻微 GEMM 退化,但通信隐藏到位)。
论文给出:TP-Overlapping 让 E2E layer 延迟降低约 1.57×(注意:通信时间本身没变,省下来的是“被隐藏的等待”)。
6.3 混合分片数据并行(HSDP):FTAR Ring AllReduce
HSDP 是 Meta 在“数据并行 + 模型分片”之间取的折中:每个 replica group 内部做 AllReduce,group 之间做 all-gather/sharded 同步。FTAR(Fault Tolerant AllReduce) 是 NCCLX 给 HSDP 定制的容错 Ring AllReduce。
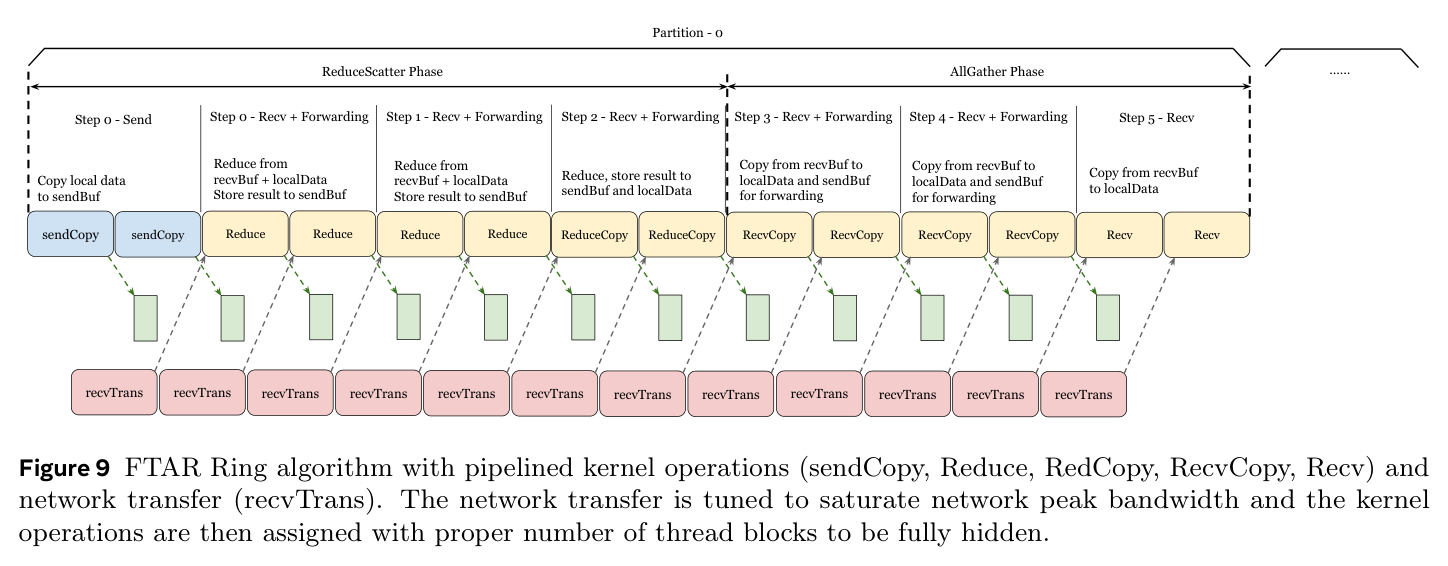
图 9:FTAR 的 Ring AllReduce 结构,含 shrink / grow 阶段以支持故障后的副本组收缩与恢复。
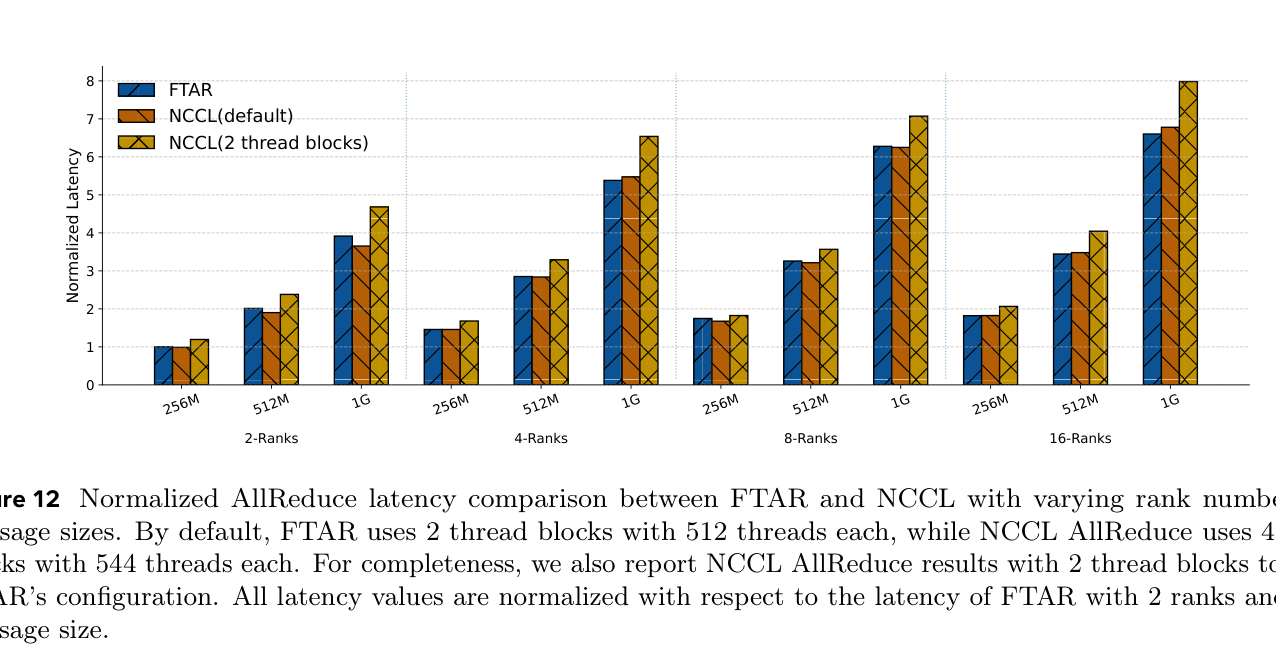
图 12:FTAR 与 baseline NCCL AllReduce 的延迟对比。等量 SM 下 FTAR 低 9%–18%;半量 SM 即可追平 NCCL。
FTAR 的实现要点:8MB chunk 切分、2 个 thread block × 512 线程、Ring 算法 + 在故障发生时对 replica group 做 shrink/grow。它把“容错”从训练框架层下沉到了集合通信层——当 10 万卡规模下硬件故障是常态(Llama3.1 训练 54 天 419 次意外中断),这一点是刚需而非锦上添花。
原文品读(算法层面):FTAR 的 shrink/grow 阶段本身不是新算法(类似 FT-MPI 2001 的 communicator 重建语义),但把它塞进 Ring AllReduce 的流水线、并与 NCCLX 的 process group 生命周期绑定,是工程上的实质创新。真正值得注意的是它的资源效率:半量 SM 追平 NCCL,意味着在故障频发、需要频繁重建通信组的场景里,NCCLX 把“容错开销”压到了接近零。
7. 推理场景定制:EP / GPU-resident / Low-latency
推理侧(尤其 MoE)是 NCCLX 另一个高光区。MoE 的 AllToAll(token dispatch/combine)是推理延迟的头号杀手,而 CUDA graph 的静态形状约束让传统 AllToAll 在变长 token 下被迫 padding。
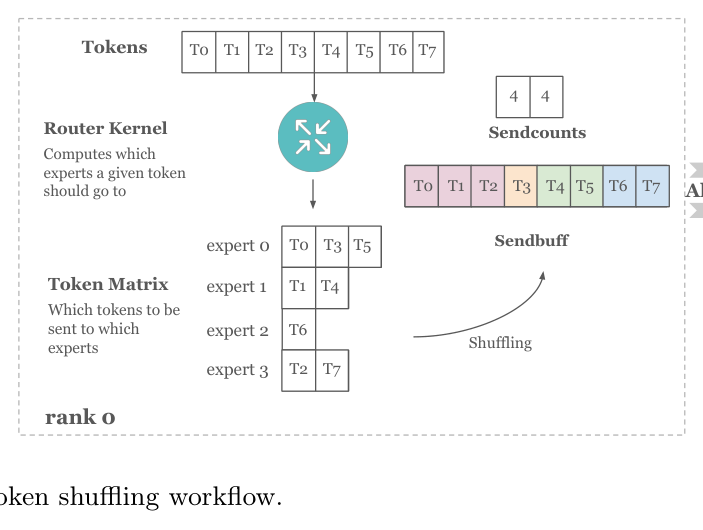
图 13:MoE 的 token shuffle(dispatch)与 combine 流程,AllToAll 在此处成为端到端延迟的主导项。
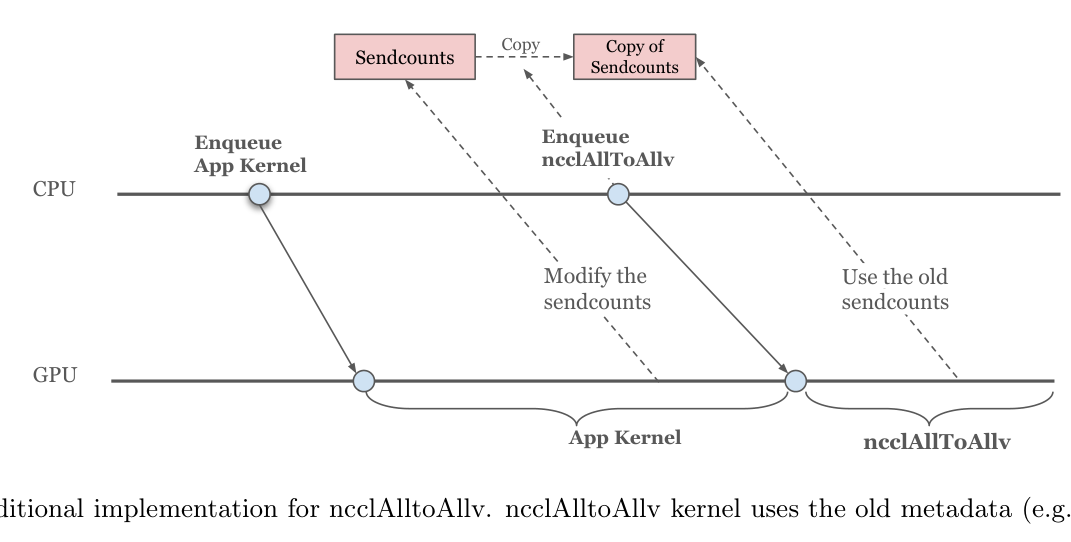
图 15:传统 AllToAllv,元数据常驻 CPU,CUDA graph 必须按最大形状 padding,造成算力浪费。
与之对照的是 eager 模式与 graph 模式的取舍(Fig.14):eager 模式下每次 launch 都有 CPU 开销但在变长负载下灵活;CUDA graph 把整段录制为静态图,省掉 launch 开销却被迫按最大形状 padding。GPU-resident metadata 正是为了让 AllToAllvDynamic 在 graph 模式下也能吃上“零 padding”的红利。
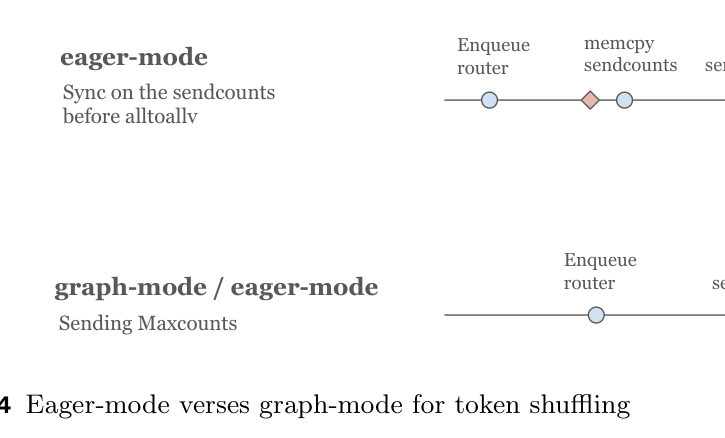
图 14:eager vs CUDA graph 模式的延迟构成。graph 模式通过消除 kernel launch 开销降低延迟,但要求静态形状——这正是传统 AllToAllv 在 MoE 变长负载下的死穴。
NCCLX 的解法叫 AllToAllvDynamic,核心是 GPU-resident metadata:通信元数据常驻 GPU、以引用(by reference)方式传递,支持动态形状,彻底绕开 CUDA graph padding。
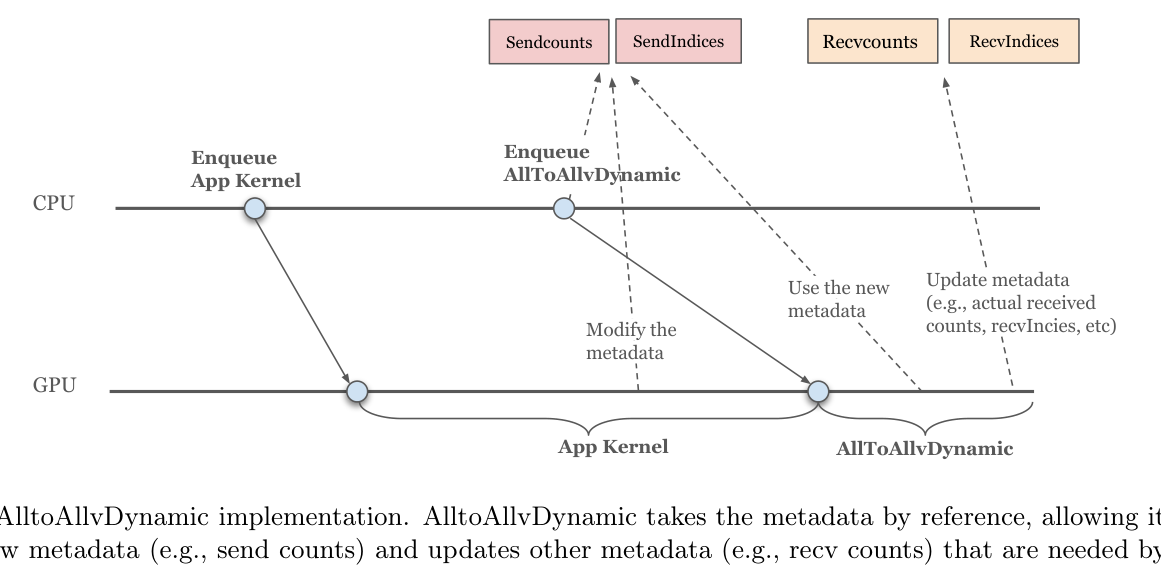
图 16:AllToAllvDynamic——元数据在 GPU 上,按实际路由结果精确发送,无需 padding。
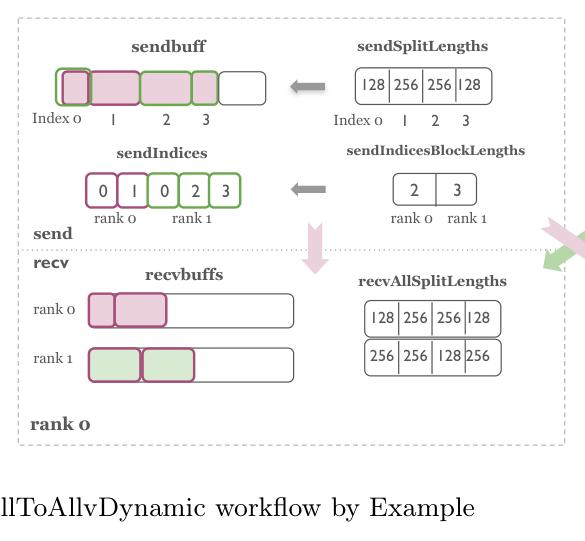
图 17:AllToAllvDynamic 的工作流,元数据在 GPU 常驻、由 kernel 直接消费。
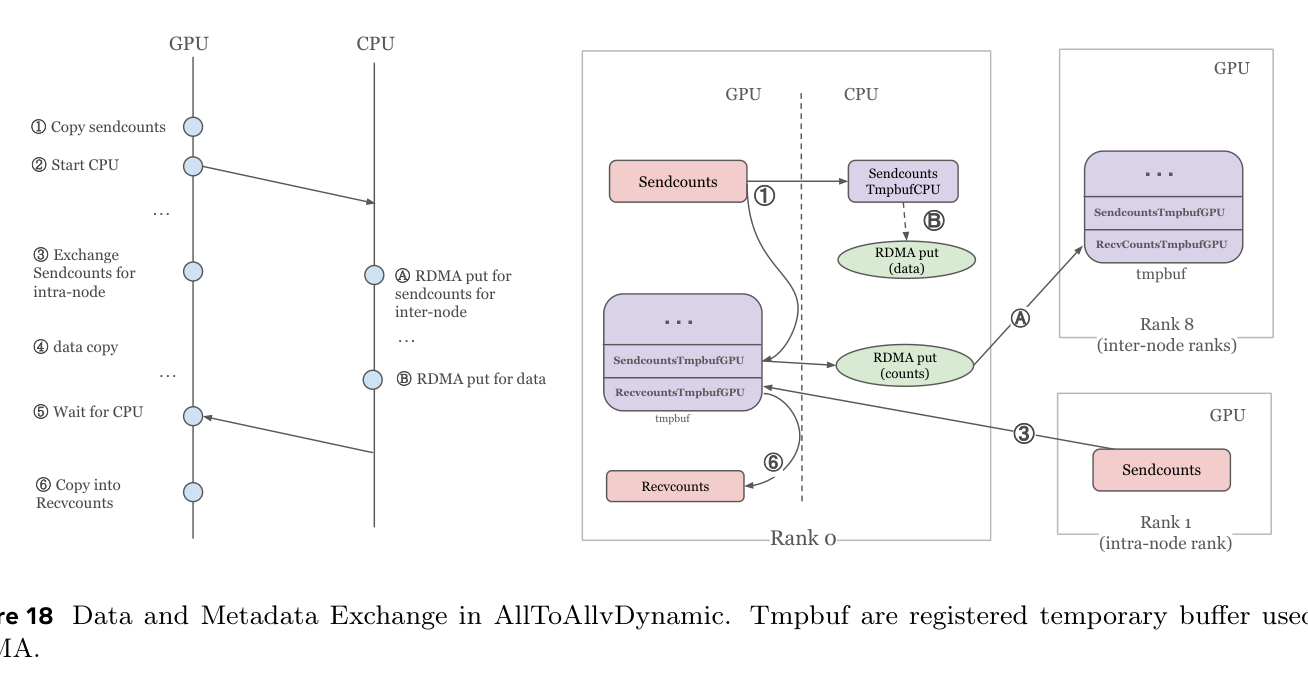
图 18:GPU-resident 元数据在 rank 间的交换方式,省去 CPU 中转。
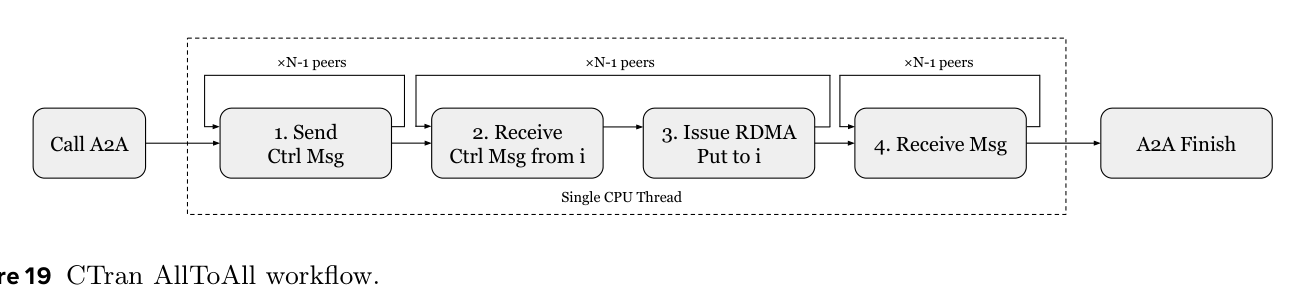
图 19:CTran 视角下的 AllToAll 数据面,zero-copy RDMA 直连用户缓冲。
论文用 Table 2 把 AllToAll 延迟拆开,结论很说明问题:
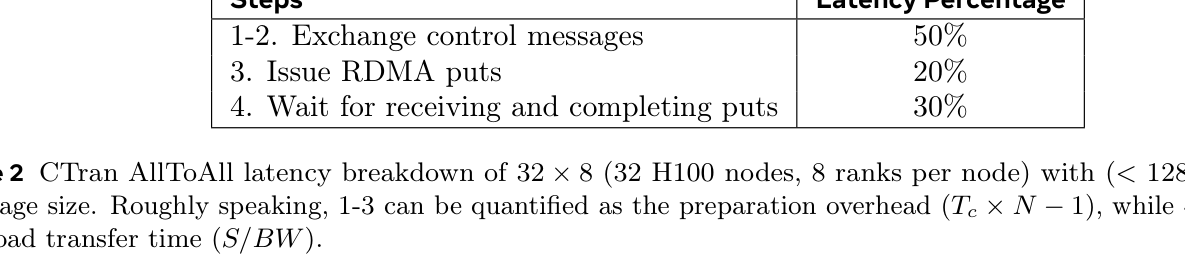
表 2:CTran AllToAll 延迟分解(32×8,8MB 消息)。控制消息交换占 ~50%,RDMA PUT ~20%,等待 ~30%——说明推理 AllToAll 的瓶颈在“控制面”而非“数据面”。
Low-latency 优化针对的正是这 50% 的控制开销:
- small-message fast path:小消息走专用快速通道;
- 控制消息交换优化 + 双缓冲:减少握手轮次;
- work request chaining / scatter list:把多个 WR 链成一条,降低 per-WR 提交开销。
用 LogP 模型表达单跳延迟:T = Tc·(N−1) + S/BW,其中 Tc 是控制开销、S 是消息量。Low-latency 优化的全部努力,都在压 Tc。
量化收益(Table 3):单节点 k=1 最高 43% 提升,分布式配置 15%–80% 提升。
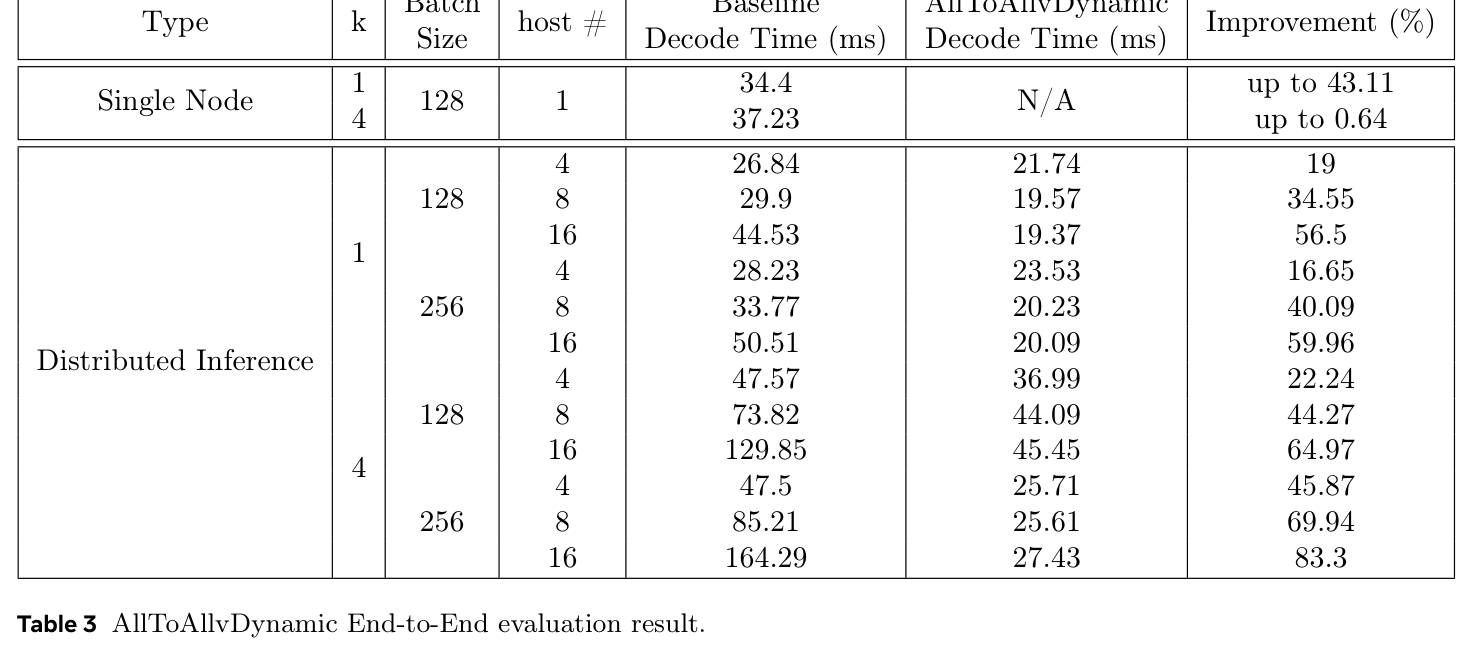
表 3:AllToAllvDynamic 端到端评估。相对单节点基线最高 43%,相对分布式基线 15%–80%。
观点:GPU-resident metadata 对 decode 阶段(小 batch、变长、延迟敏感)是结构性红利;但对 prefill 阶段(大 batch、形状相对固定)收益相对有限。这也是为什么论文的 decode 延迟提升上限给到 80% 而 prefill 没那么夸张——读这类数字要分清负载画像。
8. 初始化、资源、故障与可观测性:被低估的“另一半工程”
论文有相当篇幅在讲“初始化、内存、故障、观测”,这部分常被读者跳过,但在 100k 规模,这部分才是决定“能不能跑起来”的工程主战场。
先把全景摆出来——下图是 NCCLX 工具链在软件栈中的位置,它清楚地表明:可观测性与故障定位不是“附属功能”,而是与 CTran 传输层并列的一等公民。
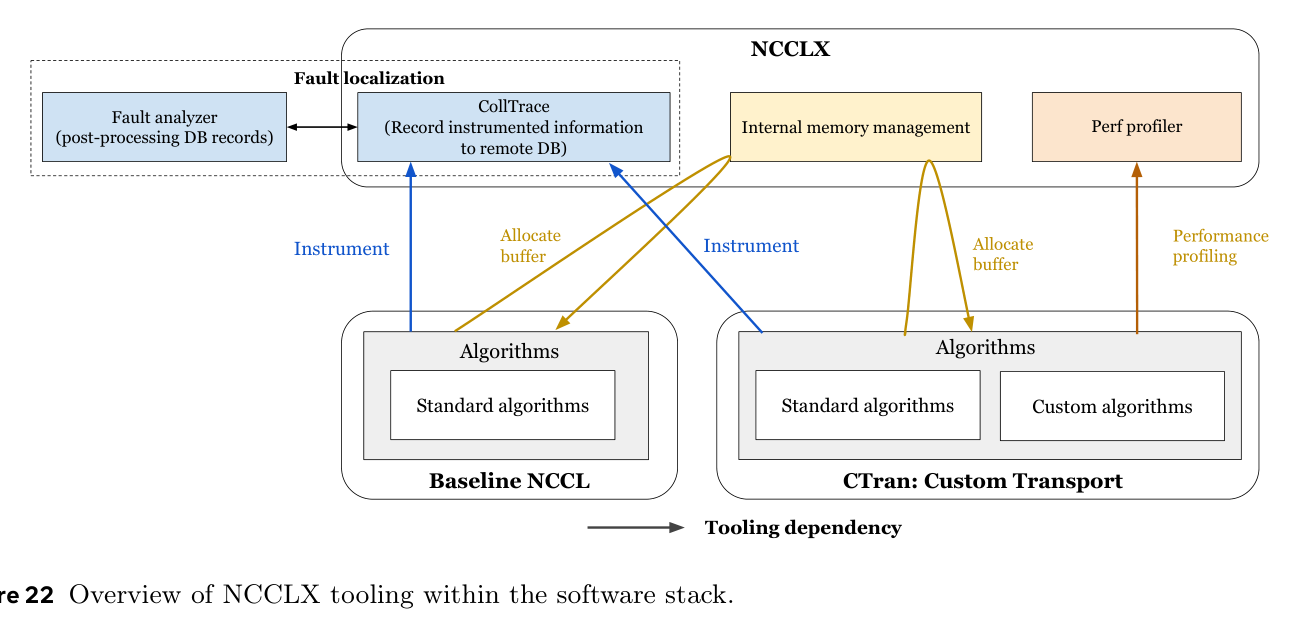
图 22:NCCLX 工具链在软件栈中的层级——传输层(CTran)、集合引擎、初始化/资源管理层、可观测性与故障定位层自底向上协同。
8.1 可扩展初始化:O(N²) → O(N)
baseline NCCL 的初始化在 96K 规模要 4 分钟以上。论文直言:
“The initialization technique employed by baseline NCCL presents three challenges: Network-Level Bottlenecks … Computational Complexity Issues … Topology computation exhibits O(N²) complexity, consuming 10s at 48K ranks and projecting to around 100s at 100K scale … Resource Allocation Dynamics … At 96K scale, initialization using baseline NCCL requires over 4 minutes.”
NCCLX 的解法:Global Process Group + Bootstrap Ring Formation(每个 rank 只连邻居,环形建立,而非都打 rank 0)+ CTran lazy connect(用的时候才建连)。
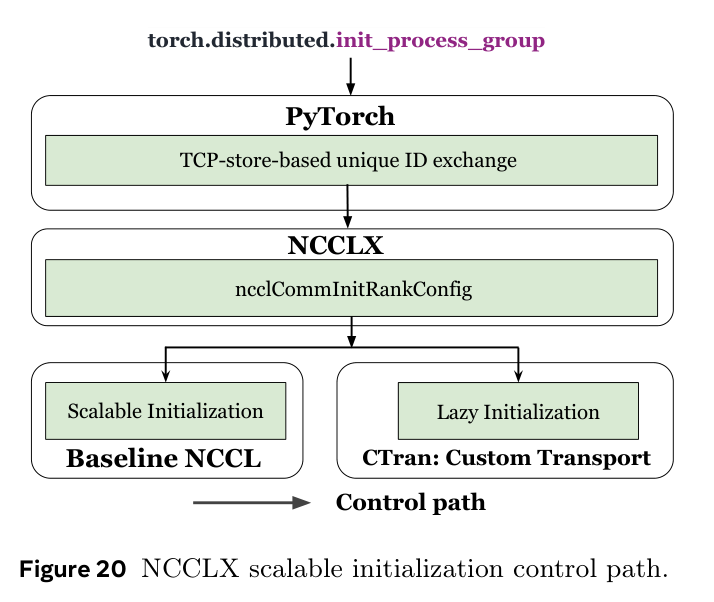
图 20:NCCLX 可扩展初始化的控制路径——ring formation 替代星型打 rank 0。
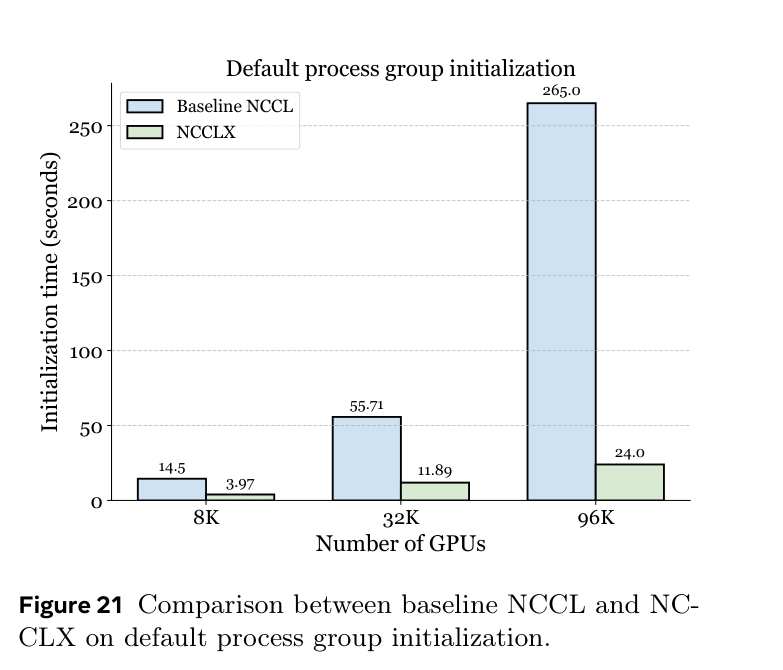
图 21:初始化性能对比。8K/32K/96K:基线 14.5/55.71/265.0s vs NCCLX 3.97/11.89/24.0s,96K 提速约 11×。
8.2 内部管理:Lazy + Slab
论文指出 NCCL 资源低效的三个根因:
“There are three fundamental design choices causing resource inefficiency in NCCL: Eager resource allocation … Multi-channel Designs … Store Metadata on HBM … such metadata also scales with the number of ranks in a communicator, which can accumulate to more than 1 GB at 100k GPU scale.”
NCCLX 的对策是 Lazy Algorithm/Channel Allocation(用时才分配、按需增长)+ Slab Allocator(对象缓存式内存池,源自 Jeff Bonwick 1994 的 Solaris slab 思想,把高频小对象的构造/析构开销降到最低)。
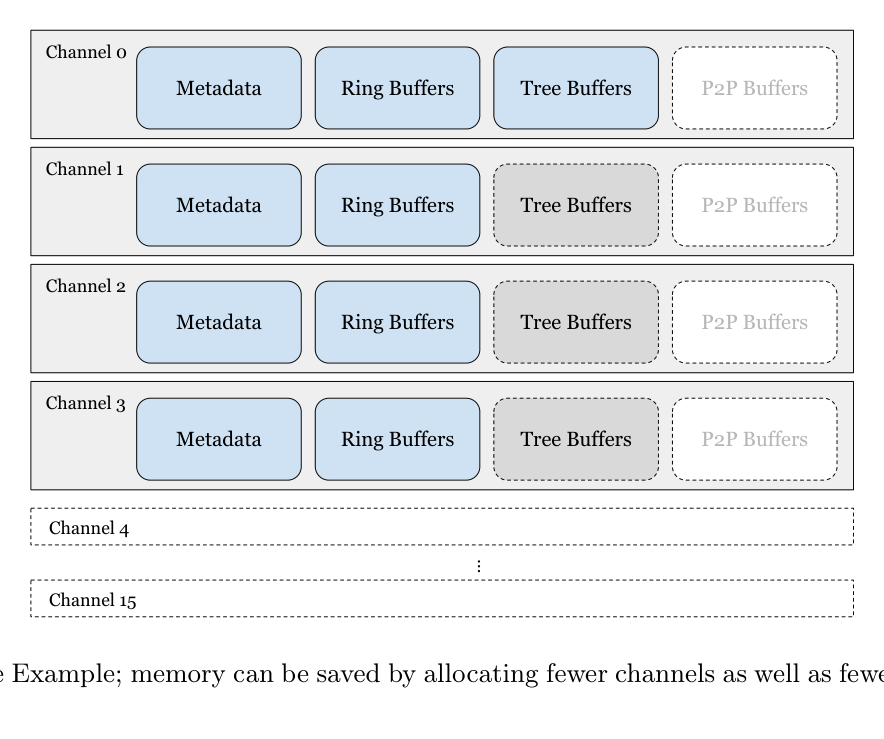
图 23:Lazy algorithm / channel allocation / connect 的触发时机。
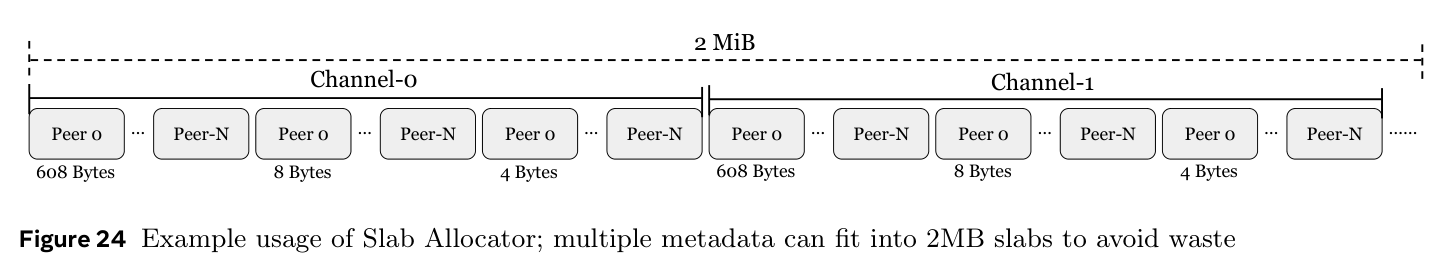
图 24:Slab Allocator 的对象缓存结构,避免每次集合都向 page allocator 申请/释放。
8.3 故障定位与可观测性
NCCLX 配了 Fault Analyzer + CollTrace,并与 PyTorch 的 NCCL flight recorder 联动——在 NCCLX Watchdog / Heartbeat 超时时自动导出跟踪。这直接服务于 Llama3.1 那次著名的“54 天 419 次意外中断、仍保持 90%+ 有效训练时间”的实战。
性能侧还有 AlgoProfiler / SlowRankDetector / QueuePairProfiler(依赖 PTP 时间同步对齐各 rank 时序)。
8.4 CPU Emulation:在机房没建完就调通通信库
这是最被低估的一招:NCCLX 提供 CPU emulation——用 mock 的 CUDA / RDMA 实现,通过 LD_LIBRARY_PATH 替换,在纯 CPU 集群上跑通全部通信逻辑。论文说 96K 规模下用 3072 台 CPU 服务器做仿真验证。
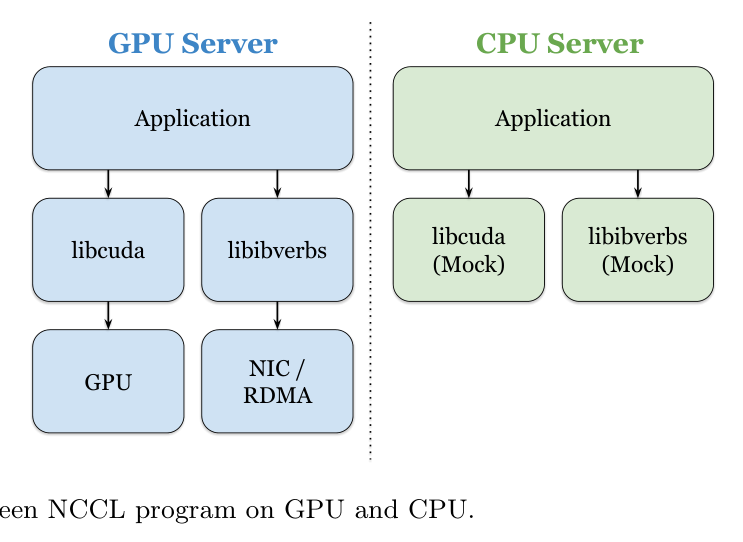
图 25:GPU 与 CPU emulation 的代码路径对比,控制逻辑完全复用,仅底层 transport 被 mock。
观点:CPU emulation 是 Meta 能“在网络/机房尚未完全就绪时就并行开发并验证 NCCLX”的关键工程杠杆。但它也是巨大的维护负担——等于要维护两套 transport 语义的一致性。这再次印证:NCCLX 的工程量,远超“一个通信库”。
9. 组织归因:康威定律下的 Meta 工程
用康威定律(Conway’s Law)回看 NCCLX,结论很清楚:系统的架构,复制了组织的边界与能力。
- 自研 RoCE + 自运维交换机 + 自研调度:Meta 不买“黑盒 IB 集群”,而是自己定义 ATSW/CTSW/RTSW、自己调 VOQ/ECN、自己写调度把作业按拓扑亲和摆放。于是通信库必须同时理解训练与推理、必须按拓扑分层调参——这是 NCCL(面向通用 NVIDIA 生态)不会去做的事。
- 与 NVIDIA 的博弈:NCCL 是“通用最大公约数”,必须为所有客户、所有硬件、所有框架妥协;NCCLX 是“Llama4 的专属驱动”,只为 Meta 自己的 H100 + RoCE + PyTorch 栈优化。这不是 fork 之争,而是“谁控制通信栈的关键路径”之争。 Meta 把控制面搬到 CPU,某种程度上也是在把“对 GPU 驱动、对 NCCL 发布节奏”的依赖降到最低。
- 与同行的横向对比(下表是本文结合公开资料整理,标注【待核实】项以公开资料为准):
| 厂商 / 项目 | 网络底座 | 通信 / 集合栈 | 差异化机制 | 与 NCCLX 对照 |
|---|---|---|---|---|
| Meta / NCCLX | 自建 RoCEv2 三层 Clos(RTSW/CTSW/ATSW),76 正交平面 | Host-driven CTran + DQPLB + FTAR + GPU-resident | 控制面在 CPU、软件 credit 流控、CUDA graph 友好 | 本文主体 |
| Google / TPU + Jupiter-Virgo | 3D Torus(训练)/ Board Fly(推理)+ OCS 光交换 Virgo | TPU Direct(RDMA 式)+ CAE(片上集合加速引擎) | 集合操作卸载到芯片硬件(CAE),ICI 互联 | 把“集合”下沉到 silicon,而非 CPU;路线更激进 |
| AWS / EFA + Trainium | EFA SRD(Scalable Reliable Datagram),packet-level 多路径 | NCCL 插件 + SRD 传输 | 用 SRD 的可靠数据报替代有序 QP,规避 incast | 在网络层用 SRD 解决 NCCLX 在软件层用 DQPLB 解决的问题 |
| DeepSeek / DeepEP | IB(理论兼容 RoCE) | DeepEP(MoE 专用 EP 通信库) | NVLink + IB 分层 AllToAll、low-latency decode 模式、SM 可控 | 聚焦 MoE AllToAll 单点,与 NCCLX 推理侧高度同源 |
| 阿里 / HPN | 自研 HP(High Performance)网络,双上联、多轨道 | 集合通信库(ACCL 系 / 厂商 NCCL 调优) | 多层次容错、集合算法拓扑感知 | 国内最早系统化做 AI 集群网络的团队之一 |
| 字节 / MegaScale | 自研 MegaScale 以太网 + 集合通信调优 | 训练框架内集合优化 | 大规模训练的稳定性 / 可观测性工程 | 与 NCCLX 在“工具链”维度最像 |
观点:NCCLX 不是“技术最先进”,而是“垂直整合最彻底”。Google 把集合卸载到芯片(CAE),AWS 把可靠性做到网络层(SRD),DeepSeek 把 MoE AllToAll 做成独立库(DeepEP),而 Meta 选择在软件栈(CPU + PyTorch + RoCE)上把通信重新做一遍。四条路线没有绝对优劣,取决于你手里握着哪层控制权。
10. 适用边界:谁能抄?谁不能抄?
这是本文最想提醒年轻工程师的一段——不要看到 12% / 11× / 80% 就准备照搬。
10.1 舒适区(N 条件,尽量同时满足收益最大)
- 硬件是 NVIDIA H100/H200 等 Hopper+,NIC 支持 RDMA(RoCE 或 IB);
- 软件栈基于 PyTorch,且愿意改动 CCA / 框架层(NCCLX 侵入了 PyTorch 内存分配器);
- 规模进入 万卡以上,且拓扑有明显的层次化异质性(跨机架/跨楼/跨 DC 延迟差数倍);
- 工作负载是 多维并行(TP/PP/HSDP)训练 或 MoE AllToAll 推理;
- 具备 自运维网络能力(能调 VOQ、能部署 deep-buffer 交换机、能接受“软件 credit 流控”)。
10.2 三类不适配
- 非 NVIDIA 生态(AMD MI 系列、昇腾、自研芯片):CTran 的 RDMA WRITE_WITH_IMM 编码、CUDA graph 常驻元数据都绑定 CUDA/NV 体系,移植成本极高。
- 小规模同构集群(< 千卡、单楼、延迟均匀):DQPLB 的分层参数、跨 DC 弹性、初始化 O(N) 优化全部“无的放矢”,收益趋近于零,反而引入 CPU 控制面复杂度。
- CPU 调度主导或嵌入式推理:Host-driven 的红利建立在“GPU 计算贵、CPU 调度便宜”的假设上;若负载本就 CPU 重,控制面反而成负担。
10.3 分群体建议
- 云厂商 / 头部 AI Lab:可直接借鉴 DQPLB(纯软件、RoCE 友好)、Lazy + Slab 资源管理、CPU emulation 验证方法论;但要评估“侵入 PyTorch CCA”的组织成本。
- 中小团队 / 学术集群:优先吃“低垂果实”——用 NCCL 官方新特性(NVLS/PAT)+ 拓扑感知调度 + 故障重放(flight recorder)即可拿到大部分收益,不必自建 CTran。
- MoE 推理团队:重点看 AllToAllvDynamic 与 DeepEP 两条线,二者同源,选最贴合自己框架的那个落地。
11. 结语:NCCLX 真正教给我们什么
回到开头那句话——NCCLX 不是“更快的 NCCL”,而是一次把通信从 GPU kernel 里“搬”出来、按拓扑和 workload 重新设计的系统工程。
它的价值不藏在任何一个单点 trick 里,而藏在三件事的叠加:
- 控制面与数据面彻底分离(Host-driven + Zero-copy),把 SM 还给计算;
- 通信库与网络协同设计(DQPLB 的软件 credit 流控),在 RoCE 上重建 IB 级可靠性;
- 通信库与框架内存管理深度耦合(CCA 扩展、GPU-resident 元数据),让 CUDA graph 与变长推理共存。
但这篇论文也留下开放问题:Device-initiated API 何时成熟?NCCLX 与 NVIDIA NCCL 主线会长期双轨还是终将合并?在“非 NVIDIA 万卡集群”成为现实的未来,这套范式能否跨芯片移植?
最后一句给年轻工程师:当你下一次被 NCCL 的 hang、慢、OOM 折磨时,先别急着调 NCCL_* 环境变量——先问自己:我的通信栈,是否真的理解了我脚下的网络拓扑和框架内存模型? NCCLX 的答案,是把这三者当成同一个系统来设计。这,才是它最该被抄走的部分。
12. 参考材料
- Min Si, Pavan Balaji, James Hongyi Zeng, et al. Collective Communication for 100k+ GPUs (NCCLX). Meta, arXiv:2510.20171v4, 2026.01.
- Meta Engineering. Building Meta’s GenAI infrastructure on RoCEv2 networks (2024.08). 公开工程博客。
- Rohit Puri, Henny. Scaling AI Network Infrastructure for Large Language Model Training at 100K+ GPU Scale(Llama3→Llama4 网络演进案例)。
- Gangidi et al. Revealing the Hidden Scalability Challenge in Large-Scale Distributed Inference (SIGCOMM 2024,RoCE 拥塞控制与 deep-buffer 交换机相关)。
- Jeff Bonwick. The Slab Allocator: An Object-Caching Kernel Memory Allocator. USENIX Summer 1994.(NCCLX Slab Allocator 思想源头)
- MPI Forum. MPI-2 / MPI-3 RMA(One-Sided Communication) (1997 / 2012)。(TP Put API 语义源头)
- Graham Fagg, Jack Dongarra. FT-MPI: Fault Tolerant MPI (ICCS 2001)。(FTAR shrink/grow 语义远祖)
- Baidu SVAIL. Ring AllReduce for Deep Learning (2017)。(Ring AllReduce 引入 DL 的开端)
- DeepSeek-AI. DeepEP: Expert Parallelism Communication Library (2025)。(MoE AllToAll 的同源路线)
- Google. Jupiter / Virgo DCN, TPU Direct, CAE 系列公开资料。(芯片级集合卸载对照)
- AWS. EFA / Scalable Reliable Datagram (SRD) 公开文档。(网络层可靠性对照)
- xCCL Survey (Lu et al., JCST 2023)。Industry-led Collective Communication Libraries。(NCCL/ACCL/MSCCL 全景)
13. 术语表(23 条)
| 术语 | 含义 |
|---|---|
| NCCLX | Meta 在 NCCL 之上开发的、面向 100k+ GPU 的集合通信框架,位于 PyTorch 之下,统管训练与推理通信。 |
| CTran | NCCLX 的自定义传输层(Custom Transport),Host-driven、zero-copy、SM-free。 |
| Host-driven | 控制平面(协议/同步/重传)由 CPU 线程驱动,而非 CUDA kernel。 |
| Zero-copy | NIC 直接对用户缓冲做 RDMA,消除中间 FIFO 暂存与 D2D 拷贝。 |
| SM-free | 数据面传输不占用 GPU 的 Streaming Multiprocessor。 |
| DQPLB | Dynamic Queue Pair Load Balancing,按拓扑分层配置 QP 数与在途字节的软件流控。 |
| RDMA WRITE_WITH_IMM | 带 32-bit immediate 的 RDMA 写,NCCLX 用它编码序号/路径/通知标志。 |
| GPU-resident metadata | 通信元数据常驻 GPU、以引用传递,避免 CUDA graph padding。 |
| AllToAllvDynamic | NCCLX 面向 MoE 的动态形状 AllToAll,绕开静态图约束。 |
| FTAR | Fault Tolerant AllReduce,HSDP 下的容错 Ring AllReduce(含 shrink/grow)。 |
| HSDP | Hybrid Sharded Data Parallelism,replica group 内 AllReduce + group 间分片同步。 |
| TP / PP / DP | 张量并行 / 流水线并行 / 数据并行。 |
| EP(Expert Parallelism) | MoE 中专家跨设备切分,依赖 AllToAll 通信。 |
| CUDA graph | 把一连串 kernel 录制为图、一次性重放,消除 launch 开销;要求形状静态。 |
| Tensor Registration | 把 GPU 缓冲 pin-down 并登记给 RDMA,使 NIC 可直访。 |
| Lazy registration | tensor 首次用于集合通信时才真正做网络注册。 |
| CCA | CUDA Cache Allocator(PyTorch 内存分配器),NCCLX 扩展其注册与内存池。 |
| Slab Allocator | 对象缓存式内存池(Bonwick 1994),降低高频小对象分配开销。 |
| Bootstrap Ring Formation | 各 rank 仅连邻居环形建组,避免都打 rank 0 的星型瓶颈。 |
| CollTrace / Fault Analyzer | NCCLX 的集体通信追踪与故障定位工具。 |
| NCCL flight recorder | PyTorch 内置的集体元数据环形缓冲记录器,与 NCCLX 联动。 |
| CPU emulation | 用 mock CUDA/RDMA 在纯 CPU 集群验证通信逻辑(LD_LIBRARY_PATH 替换)。 |
| OOO + 滑动窗口 | 接收端乱序跟踪 + 滑动窗口保序,恢复 zero-copy RDMA 的流控语义。 |
| ATSW / CTSW / RTSW | 聚合训练交换机(跨楼 Super-Spine)/ 集群 Spine(Zone 内)/ 机架 Leaf。 |
| 正交平面(orthogonal plane) | 同序号 ATSW 跨楼 Full Mesh 构成的独立故障隔离域(76 个)。 |
本文为基于 Meta 论文 arXiv:2510.20171v4 的深度技术解读,所有原图来自论文 PDF 直接提取,观点与事实分离标注。量化数据均引自原论文图表;横向厂商对比部分结合公开资料整理,标注【待核实】者以厂商官方发布为准。