Mooncake 深度解读:用存储换算力——KVCache 中心化解耦架构的工程哲学
把 KV Cache 从推理副产品提升为系统调度中枢,连接分布式存储、传输引擎与 P/D 分离。
一、引言
Mooncake 不应被简单理解为“月之暗面做的又一个 P/D 分离推理系统”。
更准确地说,它是业界首个在生产环境中验证了“以 KVCache 为调度中枢”这一设计哲学的大规模 LLM 推理系统。P/D 分离只是它的骨架,真正的血肉是围绕 KVCache 构建的分布式缓存池、高速传输引擎和全局调度器三者的协同。
这套方案的五个关键词是:
- MOONCAKE Store:聚合 GPU 集群中被浪费的 CPU/DRAM/SSD/RDMA NIC 资源,构建跨节点共享的分布式 KVCache 池,使缓存容量从单节点级跃升到集群级;
- Transfer Engine:基于 RDMA 的高性能零拷贝传输引擎,通过拓扑感知路径选择和多网卡聚合,将跨节点 KVCache 传输带宽推到硬件极限;
- KVCache-centric Scheduling:Conductor 全局调度器以 KVCache 分布和复用率为核心决策因子,而非传统的队列深度或 GPU 利用率;
- CPP(Chunked Pipeline Parallelism):首次将流水线并行从训练引入推理,解决长上下文 prefill 的扩展性问题;
- Overload-oriented Scheduling:针对 MaaS 过载常态化的预测式早拒策略,解决 P/D 分解耦系统特有的负载波动问题。
本文将按以上五大支柱展开拆解,最后讨论组织归因、适用边界与行业借鉴。分析基于 FAST’25 论文(7 页会议版)、arXiv 技术报告(v4,23 页完整版)以及 kvcache-ai.github.io/Mooncake 开源项目文档。
二、“用更多存储换更少算力”——为什么 KVCache 值得成为系统中心
2.1 数学论证:什么时候传输 KVCache 是划算的?
论文 §2.2 给出了一个简洁而有力的数学分析,我们直接套数据来理解其含义。
对于 LLaMA3-70B 在 8×A800 上的部署(参数见表 1),单个 token 的 KVCache 大小为 320 KB(80 层 × 2(K+V) × 8(GQA) × 8192(d) × 2(BF16) / 8 = 320 KB)。如果当前请求的 prompt 长度为 n,与已有缓存共享前缀长度为 p,则复用 KVCache 节省的计算量为:
$$flops_{saved} = l \times (ap^2d + bpd^2)$$
但需要先将大小为 $p \times l \times (2d/gqa) \times s$ 的 KVCache 传输到 prefill GPU 的 HBM 中。设平均计算吞吐为 G,平均传输带宽为 B(取 $B_{h2d}$ 和 $B_{nic}$ 的较小值),则复用 KVCache 对 TTFT 有利当且仅当:
$$\frac{B}{G} > \frac{2ds}{gqa \times (apd + bd^2)}$$
套入实际数字:LLaMA3-70B,8×A800,前缀长度 p=8192:
- 右侧计算结果要求最小 B ≈ 6 GB/s(A800 场景)
- 对于 8×H800,要求提升到 19 GB/s
论文指出,由于各阶段无法完美重叠,实际带宽需求更高。但关键结论是:一张 100 Gbps NIC(≈12.5 GB/s 理论值)就足以满足 A800 场景的需求。§5.4.2 的实验进一步证实:当总通信带宽超过 100 Gbps 后,平均 TTFT 稳定在 2s 以下,显著低于重算基线。
“However, as we will demonstrate in §5.4.2, a fully utilized 100 Gbps NIC per NVIDIA A800 HGX network is sufficient to meet these criteria.”
这话说得很直白——带宽门槛没有想象中那么高,关键是能不能把带宽真正用满。这正是 Transfer Engine 要解决的问题。
2.2 容量分析:为什么本地缓存永远不够
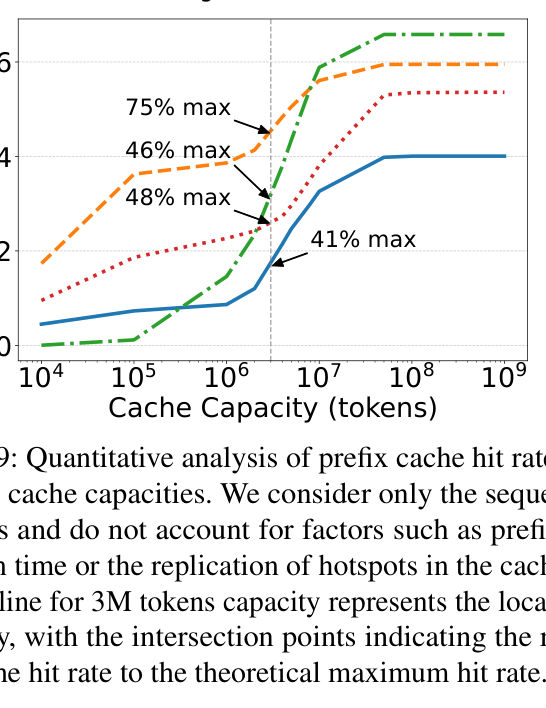
Figure 9: 不同缓存容量下前缀缓存的理论命中率的定量分析。虚线表示 3M token 的本地缓存容量,交点显示其达到理论最大命中的比例。
图上画了三种工作负载(Conversation/Tool&Agent/Synthetic)下缓存容量与命中率的关系曲线。关键数据点:
| 工作负载 | 3M token(本地)命中率 | 50M token(集群)命中率 | 达到理论最大所需容量 |
|---|---|---|---|
| Conversation | 41% max | ~75% max | ~50M tokens |
| Tool&Agent | 75% max | ~90% max | ~30M tokens |
| Synthetic | 46% max | ~95% max | ~50M tokens |
支撑本章论点:即使是最乐观的 Tool&Agent 工作负载(59% prefix cache ratio),3M token 本地缓存也只达到理论最大命中率的 75%。而 50M token 需要至少 20 个节点的 DRAM 汇聚(每节点约 1TB DRAM 可存 ~3M token @320KB/token)。这个数学事实是 MOONCAKE Store 存在的根本理由——单节点缓存容量是天花的硬约束,必须走向分布式。
三、MOONCAKE Store:分布式 KVCache 池——从“本地附带品”到“一等公民”
3.1 架构全景:KVCache 如何成为调度中枢
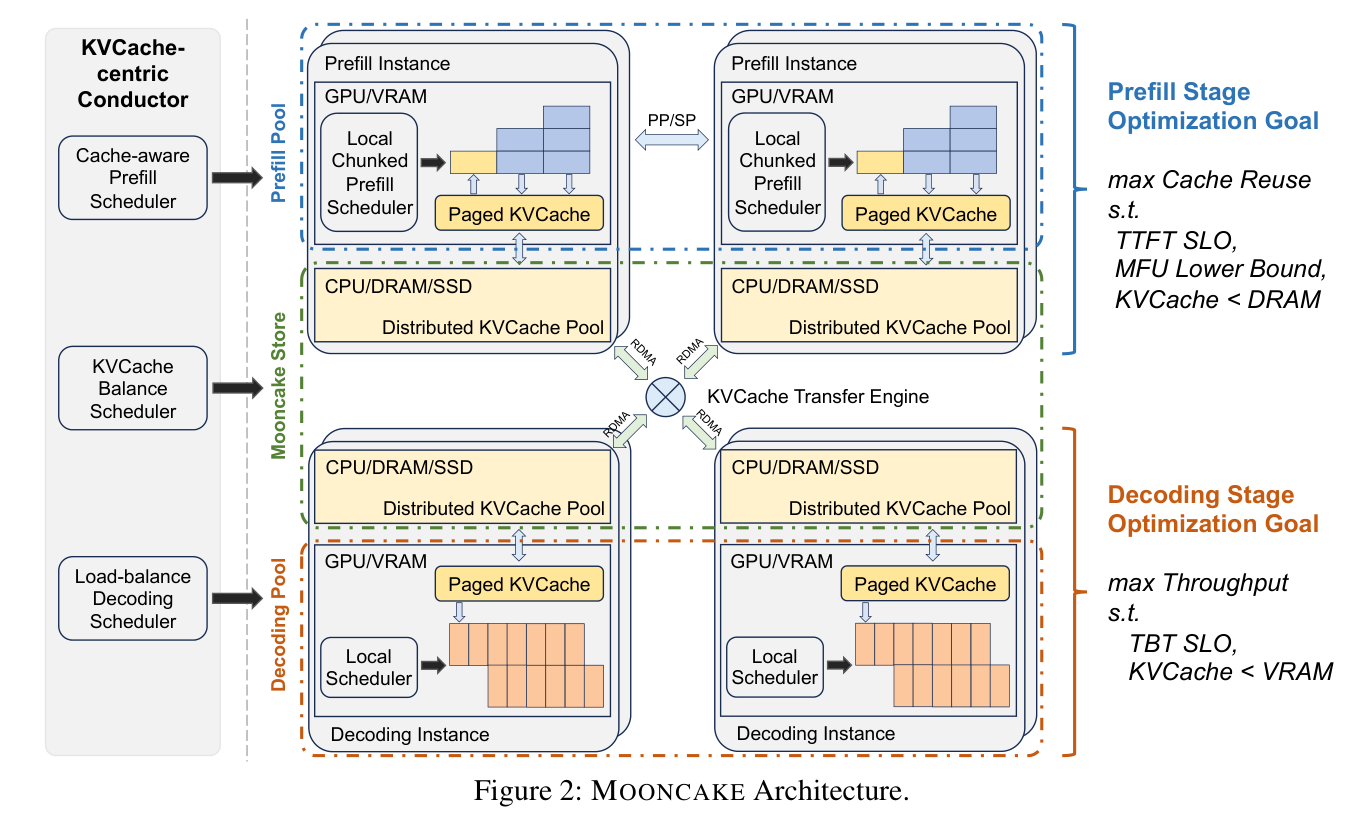
Figure 2: MOONCAKE 架构图。上半部分为 Prefill Pool(含 Cache-aware Prefill Scheduler + Chunked Prefill/CPP/SP),下半部分为 Decoding Pool(含 Load-balance Decoding Scheduler),中间通过 Conductor(KVCache-centric Conductor + KVCache Balance Scheduler)统一调度,底层由 MOONCAKE Store(Distributed KVCache Pool)和 Transfer Engine 连接所有组件。
这张图是全文最重要的架构总览。我们来逐层解读:
① 图的顶部(Prefill 侧):每个 Prefill Instance 包含 GPU/VRAM 上的 Paged KVCache + CPU/DRAM/SSD 上的 Distributed KVCache Pool。Prefill 阶段的优化目标明确标注为 max Cache Reuse,约束条件是 TTFT SLO + MFU 下界 + KVCache < DRAM。调度器是 Cache-aware Prefill Scheduler,长上下文请求使用 Chunked Prefill / CPP / SP 加速。
② 图的底部(Decoding 侧):每个 Decoding Instance 同样有本地 Paged KVCache + 分布式缓存池。Decoding 阶段优化目标是 max Throughput,约束是 TBT SLO + KVCache < VRAM。调度器是纯 Load-balance Decoding Scheduler——因为 decoding 阶段不需要考虑 cache 复用(所有 KVCache 已在 prefill 阶段生成完毕)。
③ 图的中心(Conductor):这是 Mooncake 的大脑。左侧 KVCache-centric Conductor 负责 cache-aware 的 prefill 调度,右侧 KVCache Balance Scheduler 负责热点块的复制/迁移均衡。两者共同决定每个请求路由到哪一对 (prefill, decoding) 实例。
④ 图的底层(数据平面):KVCache Transfer Engine 用 RDMA 连接所有节点的 Distributed KVCache Pool,实现跨节点 KVCache 的高速搬运。
形象地比喻:传统推理系统中 KVCache 像是每家厨房自备的调料盒——只能自己用;Mooncake 把所有厨房的调料集中到一个中央调料仓库(MOONCAKE Store),每个厨师(Prefill Instance)做菜前先去仓库领已有的底料,做完的新底料也送回仓库供别人用。Transfer Engine 就是仓库的高速传送带。
3.2 KVCache 存储机制:分块 + 哈希去重 + LRU 淘汰
MOONCAKE Store 中所有 KVCache 以 paged block 形式存储在分布式缓存池中。关键设计参数:
- Block size:每个 block 包含的 token 数,根据模型大小和网络最优传输单元确定,通常 16–512 tokens(论文实验用 256)
- Hash key:每个 block 附加一个哈希键,由自身内容的 hash 加上前缀 block 的 hash 共同确定(类似 Merkle tree / rolling hash 结构)
- 去重:相同 hash key → 相同前缀内容 → 可以复用,无需重复存储
- 副本数:同一 hash key 可有多个 replica 分布在不同节点,用于缓解热点访问延迟
- 淘汰策略:LRU(Least Recently Used),池满时驱逐最久未访问的 block(除非正在被活跃请求使用)
开源版 MOONCAKE Store(2025-2026 迭代后)在此基础上有显著增强:
- 租约机制(Lease):Get 成功后授予默认 10s TTL 租约,防止 eviction
- 软固定(Soft Pin):默认 30min TTL,内存不足时可被驱逐
- 硬固定(Hard Pin):永不被驱逐
- 分配策略可插拔:random(默认)/ free_ratio_first / ssd_free_ratio_first / cxl / local_first
- Master-Client 架构:Master 进程管理元数据和空间分配(不经过数据流),Client 同时充当客户端和服务端(贡献本地内存段)
3.3 接口设计:对象语义 + 批量传输 API
论文 Listing 1 给出了 Transfer Engine 的核心 C++ 接口:
int registerLocalMemory(void *vaddr, size_t len, const string &type);
BatchID allocateBatchID(size_t batch_size);
int submitTransfer(BatchID batch_id, const vector<Request> &entries);
int getTransferStatus(BatchID batch_id, int request_index, Status &status);
int freeBatchID(BatchID batch_id);
上层 MOONCAKE Store 在此之上提供对象级 API:put / get / change_replica(论文描述)/ Remove / Upsert / BatchUpsert(开源版增强)。关键设计特点:
- Put-End 语义:
PutStart分配空间 → 数据写入 →PutEnd提交,支持原子性写入 - Slice 级分配:大对象可切分为多个 slice,分配在不同 segment 上,利用多路径并行传输
- 异步状态查询:
getTransferStatus支持非阻塞轮询,与模型推理 overlap
3.4 天下没有免费午餐:MOONCAKE Store 的代价
第一、一致性模型是最终一致的弱语义。 Get 操作始终返回一致版本的数据,但不保证是最新的——这在推理场景可以接受(KVCache 只要多算一次不会影响正确性),但对强一致性需求场景不适用。
第二、Master 单点是可用性风险。 默认模式使用单 Master 进程管理元数据,Master 故障会导致元数据服务不可用。高可用模式需要 etcd 选主,增加了运维复杂度。【个人认为】对于 Kimi 这种单一租户场景这不是问题,但多租户部署时必须启用 HA 模式。
第三、LRU 淘汰对突发性工作负载不友好。 如果某段时间内大量冷门请求涌入,可能把后续即将使用的热门 block 淘汰掉,导致 cache thrashing。论文的 heuristic hotspot migration 能部分缓解此问题(见 §4.2),但本质上仍是 reactive 而非 predictive。
第四、SSD offload 的延迟惩罚。 开源版支持 RAM→SSD 卸载(--enable_offload=true),但 SSD 访问延迟比 DRAM 高 1-2 个数量级。对于 TTFT 敏感的场景,被卸载到 SSD 的 KVCache block 实际上等于不可用——除非预取做得足够好。
四、Transfer Engine:把多网卡 RDMA 带宽吃干榨净
4.1 为什么不用 NCCL / Gloo / TCP?
论文 §3.2.3 开宗明义地解释了为什么不选用现有方案:
“As for NCCL, it cannot gracefully handle dynamic topology changes due to the addition or removal of nodes/NICs and does not support DRAM-to-DRAM paths.”
这话说得很客气——NCCL 是为训练设计的集合通信库,不是为推理间缓存传输设计的。具体来说:
| 特性 | NCCL | Gloo (torch.distributed) | TCP | Mooncake Transfer Engine |
|---|---|---|---|---|
| DRAM↔DRAM 传输 | ❌ 不支持 | ✅ 但性能差 | ✅ 低效 | ✅ RDMA 零拷贝 |
| 动态拓扑变更 | ❌ 重连代价高 | ⚠️ 一般 | ✅ | ✅ 自动 failover |
| 多网卡聚合 | ⚠️ 受限 | ❌ | ❌ | ✅ 全网卡协作 |
| GPU Direct RDMA | ✅ | ❌ | ❌ | ✅ |
| 端点池化管理 | ❌ | ❌ | ❌ | ✅ SIEVE 淘汰 |
| 拓扑感知选路 | ❌ | ❌ | ❌ | ✅ NUMA/PCIe 感知 |
4.2 拓扑感知路径选择:知道数据该走哪条路
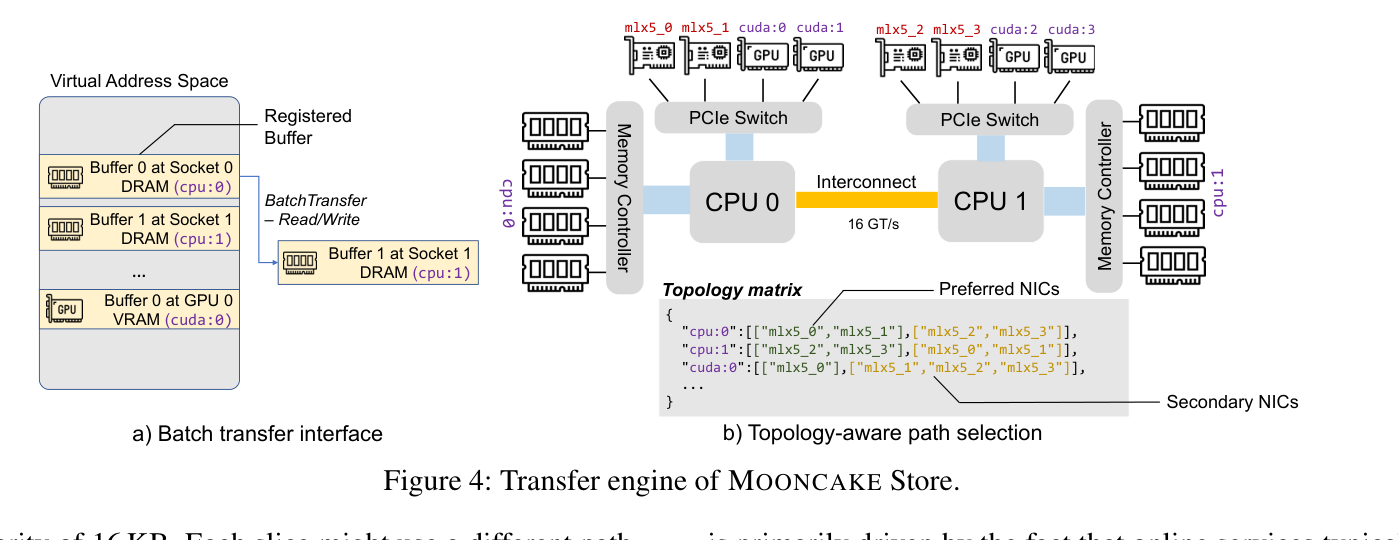
Figure 4: Transfer Engine 设计。(a) BatchTransfer 接口示意;(b) 拓扑感知路径选择——展示双路 CPU 服务器的内部互连拓扑(UPI 16 GT/s + PCIe Switch)、NIC 到 CPU/GPU 的亲和关系、以及 topology matrix 将 NIC 分类为 preferred/secondary 列表。
这是 Transfer Engine 最精巧的设计之一。我们深入到字段级来理解:
**拓扑矩阵(Topology Matrix)**的结构如下(JSON 格式):
{
  "cpu:0": [["mlx5_0", "mlx5_1"], ["mlx5_2", "mlx5_3"]],
  "cpu:1": [["mlx5_2", "mlx5_3"], ["mlx5_0", "mlx5_1"]],
  "cuda:0": [["mlx5_0"], ["mlx5_1", "mlx5_2", "mlx5_3"]],
  ...
}
每个内存区域(如 cpu:0、cuda:0)对应两个列表:
- Preferred NICs:与本区域直连(经 PCIe Switch 或 UPI 开销最小的 NIC)
- Secondary NICs:可达但路径较远的备选 NIC
工作流程(以 Fig.4b 中 buffer0→buffer1 为例):
- 引擎识别 buffer0 位于
cpu:0(Socket 0 DRAM)→ 查 topology matrix 得 preferred NIC 为mlx5_0/mlx5_1 - 识别 buffer1 位于
cpu:1(Socket 1 DRAM)→ 查 matrix 得 preferred NIC 为mlx5_2/mlx5_3 - 选择
mlx5_1@local→mlx5_3@target建立 RDMA 连接 - 数据经路径:
cpu:0 DRAM → PCIe Switch → mlx5_1 → 网络 → mlx5_3 → PCIe Switch → cpu:1 DRAM
关键细节——切片粒度:当单次传输 >64KB 时,引擎自动将请求切分为多个 16KB slice,每个 slice 可走不同的 NIC 路径。这意味着一个 40GB 的 KVCache 传输会被切分为 ~250 万个 slice,分布在 4 张 200Gbps NIC 上同时传输——所有网卡都在干活,没有任何一张空闲。
类比:这就像快递公司把一个大包裹拆成 100 个小包,分别走 4 条不同的高速公路,同时在目的地汇总。拓扑矩阵就是导航系统,确保每个小包都走了最近的出发/到达网点。
4.3 端点管理与故障处理
端点池化(Endpoint Pooling):
- 每个 Endpoint 表示一对 (local_RDMA_NIC, remote_RDMA_NIC) 的连接,包含 1+ 个 QP(Queue Pair)
- 连接按需建立——首次传输请求触发握手,之后保持
- 使用 SIEVE 算法【NSDI’24】管理端点淘汰(也可选 FIFO),限制最大活跃连接数为
MC_MAX_EP_PER_CTX(默认 65536)
故障处理:
- 单 NIC 临时不可用 → 自动切换到其他可达路径的重试
- 检测到 RDMA Context / CQ 异常 → 临时标记该资源为不可用,待链路恢复
- 连接失败 → 双向移出端点池,下次传输时重建
- 握手超时:
MC_HANDSHAKE_CONNECT_TIMEOUT默认 5s(避免阻塞数分钟)
4.4 性能实测:到底有多快?
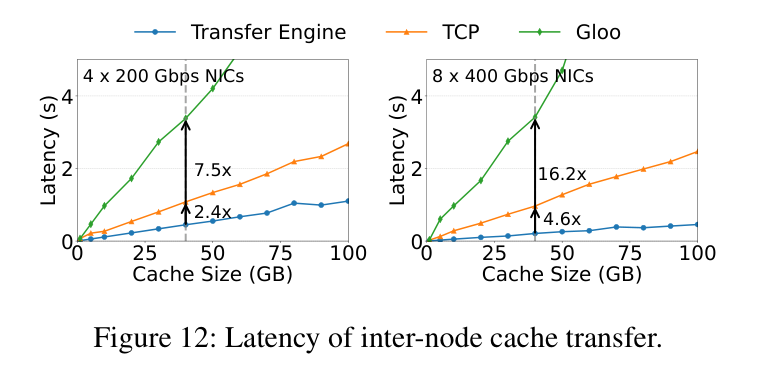
Figure 12: 跨节点缓存传输延迟对比。左图为 4×200Gbps NIC 配置,右图为 8×400Gbps NIC 配置。对比 Transfer Engine、TCP 和 Gloo 三种方案。
关键数据(传输 40GB 数据 ≈ LLaMA3-70B @128k context 的 KVCache 大小):
| 配置 | Transfer Engine | TCP | Gloo | 加速比 (vs TCP) |
|---|---|---|---|---|
| 4×200Gbps | 87 GB/s (~36s) | ~36 GB/s (~95s) | ~11.6 GB/s (~295s) | 2.4× |
| 8×400Gbps | 190 GB/s (~17s) | ~41 GB/s (~81s) | ~11.7 GB/s (~285s) | 4.6× |
支撑本章论点:Transfer Engine 在 8×400Gbps 配置下达到了 190 GB/s 的有效带宽,相当于吃满了近半数的理论聚合带宽(8×400Gbps = 400 GB/s 理论值,47.5% 效率考虑到协议开销和 slice 粒度已经非常出色)。TCP 和 Gloo 远未触及硬件极限。
开源项目文档中的 benchmark 数据进一步印证:transfer_engine_bench 在 10 秒测试中达到 379,008 IOPS 和 19.87 GiB/s 吞吐量,超过单机单卡最大吞吐。
4.5 技术溯源表
| 特性/机制 | 出处 | Mooncake 的增量 |
|---|---|---|
| RDMA-based 零拷贝传输 | GPUDirect RDMA (NVIDIA, 2010s), libibverbs | 多 NIC 聚合 + 拓扑感知选路 |
| 拓扑感知路径选择 | NUMA-aware MPI (MPICH, 2000s), DCQCN (SIGCOMM’16) | 首次应用于 LLM 推理 KVCache 传输 |
| 端点池化 + SIEVE 淘汰 | SIEVE (NSDI’24, Zhang et al.) | 直接采用,适配 RDMA QP 语义 |
| 切片化并行传输 | MPMD stripe I/O (PVFS, 2000s), iSCSI multipath | 应用于单次传输内的多 NIC 负载均衡 |
| GPU Direct RDMA | NVIDIA GDRCopy (2018), PeerMemory | 通过 WITH_NVIDIA_PEERMEM 或 DMA-BUF 双路径支持 |
| 异步批量传输接口 | IBVerbs async ops, libfabric | 封装为高层 BatchTransfer API |
判断:Transfer Engine 的单点创新有限,其价值在于将这些既有机制整合为一个面向 LLM 推理场景的高性能传输中间件,并在生产环境中验证了规模(数千节点、100B+ tokens/day)。真正的工程亮点是拓扑感知路径选择与多网卡切片聚合的结合——这是从 HPC 领域借鉴但在 AI 推理领域首次系统性实现的。
4.6 工程取舍细节
① 内存注册的隐含开销:registerLocalMemory 需要为每块内存区域注册 MR(Memory Region),涉及内核态调用。频繁注册/注销小缓冲区会成为瓶颈。Mooncake 的做法是预注册大块 local_buffer(通过 local_buffer_size 配置),在其上做 OffsetBufferAllocator 分配(~50ns/次,vs mmap ~1000ns/次)。
② 不支持 VRAM→VRAM 直传:拓扑矩阵中远程侧只有 DRAM 类型(cpu:0/cpu:1),不支持直接写入远端 GPU VRAM。这意味着解码节点收到 KVCache 后还需要一次 DRAM→HBM 的拷贝(Load Cache 步骤,见 Fig.3)。【推测】这是因为 GPUDirect RDMA 的远端写 VRAM 需要目标 GPU 的 peer 访问配置,在异构集群中难以保证。
③ MC_MTU=4096 的权衡:默认 MTU 4096 字节意味着每个 RDMA 包的有效载荷受限。大 MTU(如 9000 Jumbo Frame)能提高吞吐但增加单包延迟和丢包代价。Mooncake 选择保守值可能是为了在 RoCEv2 拥塞环境下保持稳定性。
五、请求处理的四步舞:从 Tokenize 到 Decode
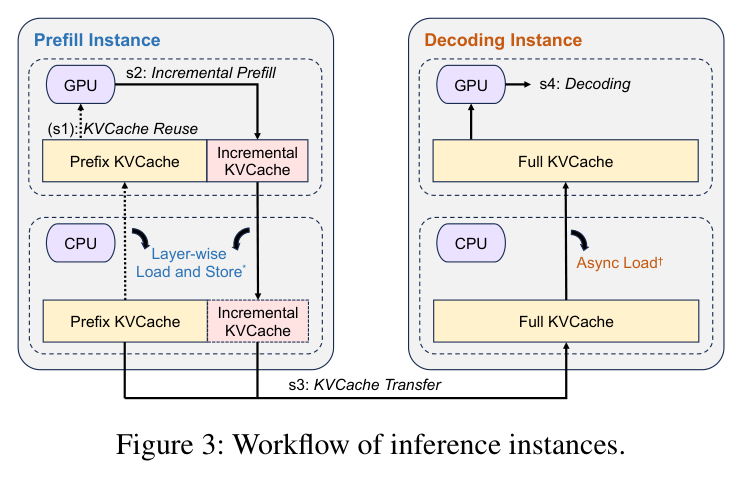
Figure 3: 推理实例的工作流。四个步骤:(s1) KVCache Reuse——从远程加载前缀缓存到 GPU;(s2) Incremental Prefill——增量计算新 token 的 KVCache 并存回 CPU;(s3) KVCache Transfer——异步流式传输到解码节点;(s4) Decoding——加入连续批处理解码。带 * 号的操作可与计算重叠,† 号的操作可异步执行。
这张图清晰地展示了 Mooncake 处理一个请求的全生命周期。我们逐步拆解:
Step 1 — KVCache Reuse (s1):Conductor 根据请求的 prompt 计算 block hash keys,与各 Prefill Instance 的本地缓存做前缀匹配。选定实例后,将该实例缺失的前缀 KVCache block 从远程 CPU 内存 RDMA 直接拉取到 GPU VRAM(Async Load†)。如果无前缀缓存则跳过。
Step 2 — Incremental Prefill (s2):Prefill Instance 以已有前缀 KVCache 为起点,仅计算新增 token 部分。每完成一层的 attention 计算,就将该层的增量 KVCache layer-wise 地异步存回 CPU 内存(Layer-wise Load and Store*)。这就是论文 §3.3(arXiv §5.2)描述的 Layer-wise Prefill 技术——将 KVCache 的 store/load 与计算完全重叠。
Step 3 — KVCache Transfer (s3):与 Step 2 并行执行。每层计算完的 KVCache 立即通过 Transfer Engine 流式传送到解码节点的 CPU 内存。不需要等全部 80 层都算完才开始传——这是减少 TTFT 的关键重叠优化。
Step 4 — Decoding (s4):解码节点的 CPU 内存收齐全部 KVCache 后,将其加载到 GPU VRAM(Async Load†),然后请求加入 continuous batching 解码队列。
关键洞察:图中带斜纹的步骤(Schedule、Transfer、Load Cache)都可以与模型推理异步并行,不影响 Mooncake 的吞吐量。唯一串行的瓶颈是 Prefill(s2)和 Decode(s4)本身的计算时间——而这正是 P/D 分离要解耦的两个东西。
六、KVCache 中心化调度:让缓存决定请求去向
6.1 Cache-Aware Prefill 调度
传统 LLM serving 系统(包括 vLLM)选择 prefill 节点的标准通常是队列最短的实例(load-balancing)。Mooncake 的核心差异在于:它同时考虑了三个因素——前缀匹配长度、实例排队时间、预估执行时间。
Algorithm 1(论文及 arXiv 版本均有给出)的核心逻辑:
对每个 request R:
  1. 计算 R 的 block_keys(前缀哈希链)
  2. 找到全局最佳前缀匹配 (best_len, best_instance)
  3. 对每个 prefill instance i:
     a. 若 best_len - i.prefix_len > threshold:
        → 需要从 best_instance 传输 KVCache
        → TTFT_i = T_transfer + T_queue + T_prefill(best_len)
     b. 否则:
        → 使用 instance i 本地缓存
        → TTFT_i = T_queue + T_prefill(i.prefix_len)
  4. 选择 TTFT 最小的 instance
  5. 选择 TBT 满足 SLO 的 decoding instance
  6. 若任一 SLO 不可达 → 返回 HTTP 429(早拒)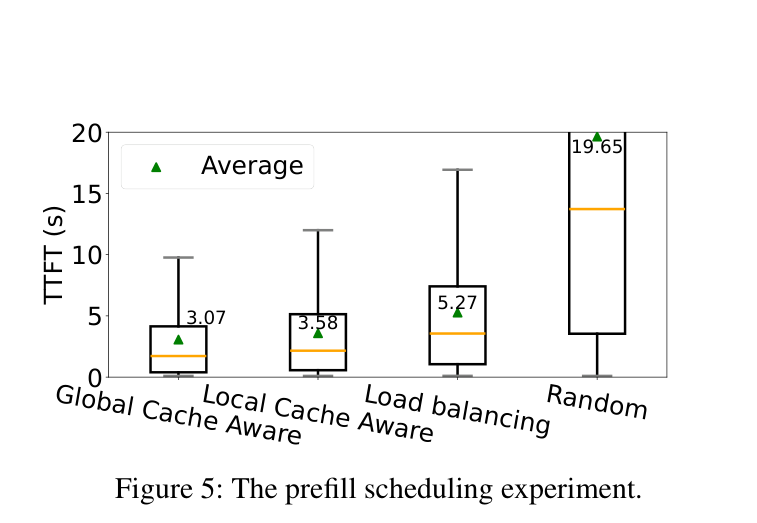
Figure 5: Prefill 调度算法对比实验。四种策略(Random / Load-balancing / Global Cache-Aware / KVCache-centric 含 Load Balancing)的平均 TTFT。
实验数据(16×8×A800 节点,23608 条真实对话 trace):
| 调度策略 | 平均 TTFT (s) | 相对 Random 的改善 |
|---|---|---|
| Random | 92.07 | baseline |
| Load-balancing | 60.41 | -34% |
| Global Cache-Aware(局部) | 3.58 | -96% |
| KVCache-centric(全局+均衡) | 3.07 | -97% |
支撑本章论点:Cache-aware 调度将 TTFT 从 92s 骤降到 3.6s(-96%),加入 load balancing 后再降 14%。这个数量级的改善说明:在 Kimi 的工作负载下(平均输入 12035 tokens,40% prefix cache ratio),cache 命中率对 TTFT 的影响远大于排队延迟。随机调度几乎必然把请求发到没有相关缓存的节点上,导致大量重复计算。
6.2 热点迁移:Heuristic 式的自动化缓存均衡
论文 §4.2(arXiv §6.2)提出的 heuristic-based automated hotspot migration 是调度算法中最有趣的部分。
问题:系统提示词(system prompt)几乎被每个请求访问,而某个用户的长文档缓存可能只有他自己用。如果总是把请求路由到缓存最长的节点,该节点会过载;如果总是路由到最闲的节点,又浪费了缓存。
解决方案(两策略组合):
策略 A — 主动拉取:当 Conductor 决定把请求调度到一个非最佳缓存节点时,如果 估算的额外 prefill 时间 < 从最佳节点传输的时间,就直接让该节点主动从最佳节点拉取 KVCache 并存到本地。这不仅减少了本次请求的 TTFT,还顺便完成了热点缓存的复制。
策略 B — 计算优于传输阈值:如果 best_remote_prefix_len ≤ local_prefix_len × threshold(threshold 当前手动调整),则宁愿本地重新计算也不传输。这避免了短前缀下的传输开销。
“Both strategies not only reduce the prefill time for requests but also facilitate the automatic replication of hotspot caches, allowing for their broader distribution across multiple instances.”
这话说得很巧妙——热点复制不是单独的后台任务,而是调度决策的副产品。每次 Conductor 为了均衡负载而把请求路由到非最佳缓存节点时,顺带就做了一次缓存复制。这种“顺手为之”的设计避免了复杂的预测式预复制机制。
6.3 天下没有免费午餐:调度的代价
第一、TTFT 预测模型的误差敏感性。 调度质量高度依赖 prefill 时间的预测精度。论文使用基于离线数据的多项式回归模型(输入:request length + prefix hit length),误差界限取决于离线数据的充分性。如果在线 workload 分布偏移(比如突然来了一批超长 document QA 请求),预测误差会增大,导致调度决策劣化。
第二、传输时间预测的不确定性。 传输时间不仅取决于数据大小,还取决于发送节点是否拥塞——这是一个动态变化的量。论文承认这是“More difficulty lies in predicting the transfer time”,解决方案是增加热点副本数,但这又消耗了额外的缓存容量和带宽。
第三、kvcache_balancing_threshold 的手动调优。 这个决定“何时值得传输 vs 何时值得重算”的阈值当前是人工调整的(论文脚注:“currently adjusted manually but can be adaptively adjusted by an algorithm in the future”)。在不同 workload 下最优值可能差异很大,固定阈值必然是 suboptimal 的。
七、CPP:把流水线并行从训练搬到推理
7.1 为什么不用 Sequence Parallelism?
论文 §3.3(arXiv §5.1)花了相当篇幅讨论为什么选择 CPP 而非 SP:
Sequence Parallelism(SP)的问题:
- SP(Ring Attention / Striped Attention 等)每层至少需要一次跨节点通信,降低了 MFU
- 短请求用 SP 反而比单节点 TP 更慢(MFU 更低)
- 弹性 SP(LoongServe, SOSP’24)需要预先建立全局通信组,增加了 Conductor 设计复杂度
- SP 的频繁跨节点通信与 KVCache 跨节点传输争抢网络资源
CPP 的优势:
- 类似训练中的 Pipeline Parallelism,仅在 pipeline stage 边界处通信,可轻松与计算重叠
- 天然适配长短混合请求:短请求自动退化为单节点处理,无需动态调整
- 论文声称这是 CPP 首次应用于推理阶段(“to our knowledge, this is the first application in the inference stage”)
7.2 CPP 工作机制
将 Prefill Cluster 中每 X 个节点分组为一个 pipelined prefill node group。对每个请求:
- 将 input tokens 按
prefill_chunk(通常 >1000 tokens)切分为多个 chunk - 不同 chunk 由 group 内不同节点同时处理(不同节点负责不同 chunk 的 layer range)
- 节点间仅在 chunk 边界处交换中间激活值(类似 PP 的 micro-batch pipeline)
类比:这就像工厂流水线——传统方式是一个工人从头到尾做整个产品(TP),SP 是多个工人轮流做同一个产品的不同零件但需要频繁交接(通信密集),CPP 是每个工人专门做一个工序,产品在工人之间流转(交接少且规则)。
7.3 技术溯源表
| 特性 | 出处 | Mooncake 的增量 |
|---|---|---|
| P/D 分离架构 | Splitwise (ISCA’24), DistServe (OSDI’24), TetriInfer (arXiv’24) | 加入分布式 KVCache 池作为第三资源池 |
| Prefix Caching / RadixAttention | Prompt Cache (MLSys’24), SGLang RadixAttention (arXiv’23), vLLM Prefix Caching | 从本地 HBM 扩展到跨节点 DRAM 池 |
| Layer-wise Prefill / Compute-Transfer Overlap | DistServe pipelined transfer (OSDI’24) | 与分布式缓存深度整合 |
| Chunked Prefill | Sarathi-Serve (OSDI’24) | 保留 disaggregated + 加入 CPP |
| Pipeline Parallelism (inference) | PipeDream (MLSys’20), Terapipe (ICML’21, training) | 首次引入推理 prefill 阶段 |
| SIEVE Cache Eviction | SIEVE (NSDI’24, Zhang et al.) | 用于 RDMA Endpoint 池淘汰 |
| Goodput Metric | DistServe (OSDI’24) | 采用并扩展(加入 overload-oriented scheduling) |
判断:Mooncake 的单点原始创新只有 CPP for inference 和 overload-oriented early rejection 两项。但其真正的价值在于整合——把 P/D 分离、prefix caching、RDMA 传输、全局调度打包成一个在生产环境中跑通的系统,并用 498% 的吞吐提升 证明了这个整合方向的价值。
八、过载导向调度:P/D 分离系统独有的挑战
“Most existing work on LLM serving assumes that all requests will be processed, optimizing the throughput or the TTFT and TBT of requests accordingly. However, in real scenarios, processing every incoming request is neither economical nor realistic.”
这话说得很坦诚——学术界假设资源无限,工业界每天面对过载。arXiv 版本的 §7(FAST’25 版因篇幅限制被大幅删减)详细讨论了这个 Moonshot AI 作为 MaaS 提供商必须面对的现实问题。
8.1 早拒(Early Rejection)及其引发的负载波动
基本思路:在请求进入 prefill 阶段之前,Conductor 就评估 prefill pool 和 decoding pool 的负载。如果预测到即使完成 prefill 也找不到能满足 TBT SLO 的 decoding slot,直接返回 HTTP 429,节省无效的 prefill 计算资源。
但 Early Rejection 引入了新的问题——负载波动:
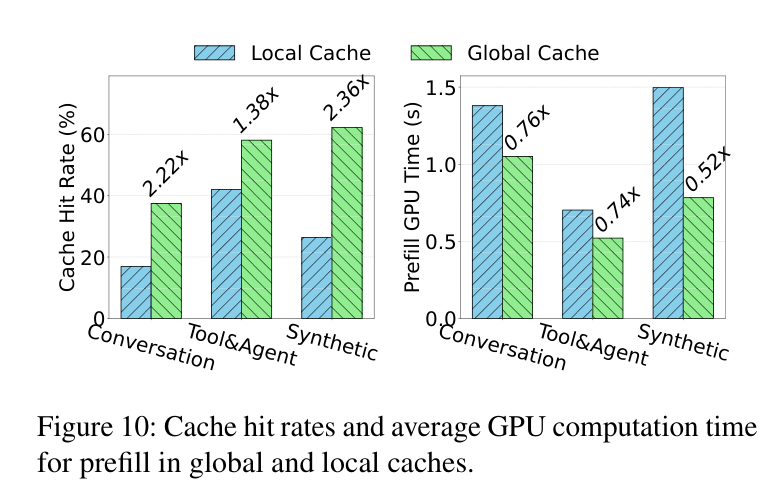
Figure 14 (arXiv Fig.10): Early Rejection 导致的 prefill/decoding 负载反相波动示意图。(a) 纯 Early Rejection:prefill 和 decoding 负载呈反相震荡——Stage 2 中 decoding 过载导致拒绝新请求 → Stage 3 中 prefill 空闲 → Stage 4 又大量接受 → 循环往复。(b) 基于预测的 Early Rejection:通过预测未来 decoding 负载平滑了波动。
论文用四阶段模型清晰解释了这个现象:
- Stage 1:Prefill 和 Decoding 都空闲 → 大量接受请求 → Prefill 迅速饱和
- Stage 2:Prefill 完成的请求涌向 Decoding → Decoding 过载 → 开始拒绝
- Stage 3:新请求被拒 → Prefill 空闲(无新请求进来)
- Stage 4:Decoding 释放出 slot → 又开始接受 → 回到 Stage 1
这种 anti-phase oscillation(反相震荡)导致集群利用率剧烈波动,大量时间处于“一边忙死一边闲死”的状态。
8.2 基于预测的早拒:平滑波动的解法
核心思想:不只看当前的 decoding 负载,而是预测 prefill 完成时刻的 decoding 负载。
两种预测路径:
Request-level:预测每个请求的输出长度 → 精确估算其 decoding 资源占用时间和后续添加的请求数。但论文坦言这对 MaaS 场景成本太高或准确率不够。
System-level(Mooncake 当前采用):
- 假设每个请求的 decoding 占用均匀时间 $t_d$
- 对给定时刻 t:
- 把 t 时刻能完成 prefill 的请求加入 decoding 实例
- 把 t 时刻前已完成的请求从 decoding 实例移除
- 计算所有 decoding 实例的平均 TBT ratio(相对于 SLO 阈值)作为负载指标
实验数据(8P+8D 集群,23000 条真实 trace,2x 加速回放模拟过载):
| 策略 | 拒绝请求数 | 有效处理请求数(隐含) |
|---|---|---|
| Baseline(decode 侧才拒) | 4183 | 最少(大量 prefill 浪费) |
| Early Rejection | 3771 | +412 |
| Early Rejection + Prediction | 3589 | +182(相对 Baseline) |
预测式早拒比 baseline 少拒绝了 594 个请求(14.2% 减少),这些节省下来的计算资源可以服务于更多有效请求。
“This straightforward implementation of such an early reject policy surprisingly leads to fluctuations in the overloads.”
“Surprisingly”这个词用得很克制——实际上这个波动问题是 P/D 分解耦系统的结构性缺陷,任何实现 Early Rejection 的 P/D 系统都会遇到。Mooncake 的贡献在于首次在公开文献中系统地描述并提出了解决方案。
九、实验数据全景:数字里的故事
9.1 端到端吞吐:真实工作负载下的表现
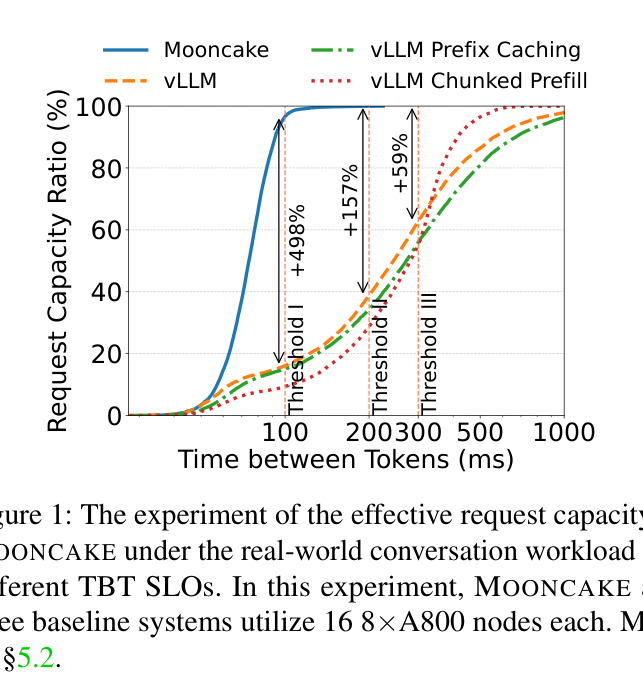
Figure 1: 真实对话工作负载下的有效请求容量。横轴为 TBT SLO 阈值(ms),纵轴为满足 SLO 的请求占比。Mooncake 在 Threshold I (100ms)、II (200ms)、III (300ms) 下分别比 vLLM 高出 +498%、+157%、+59%。
这是论文中最引人注目的实验结果。我们仔细读图:
对话工作负载特征(Table 2):平均输入 12035 tokens,平均输出 343 tokens,prefix cache ratio 40%,共 12031 条请求(1 小时 trace)。
关键观察:
- 在严格 SLO 下(Threshold I, TBT<100ms),Mooncake 的优势最大(+498%)——这说明 P/D 分离 + 全局缓存在 tail latency 场景下价值最高
- 随着 SLO 放松,vLLM(尤其是加 Prefix Caching 后)追赶很快——因为在宽松 SLO 下 vLLM 可以容忍更大的 decode 干扰
- vLLM Chunked Prefill 在中等 SLO 下表现接近 vLLM 基线——chunked prefill 减少了 decode 干扰但也牺牲了 prefill MFU, trade-off 不总是正的
9.2 Prefill GPU 时间:全局缓存省了多少算力?
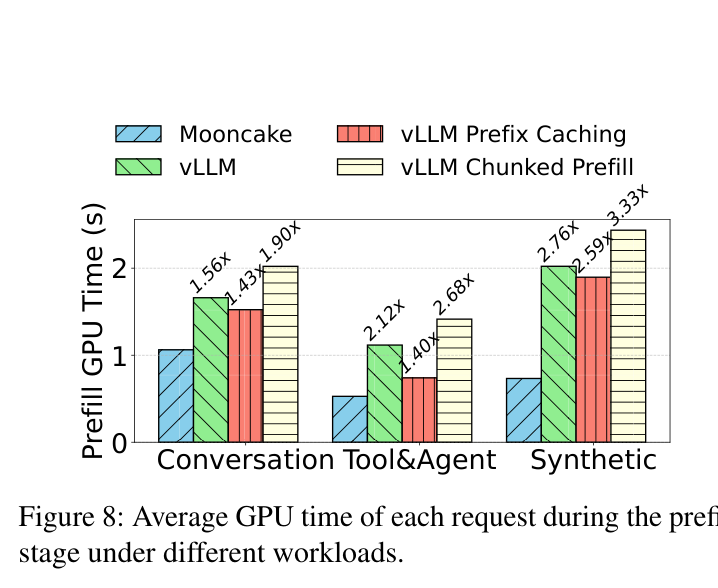
Figure 8: 三种工作负载下各系统的平均 Prefill GPU 时间。Mooncake 在 Conversation/Tool&Agent/Synthetic 下分别比 vLLM 降低 36%/53%/64%,比 vLLM Prefix Caching 降低 1.43×/1.40×/2.59×。
数据解读:
| 工作负载 | Mooncake | vLLM | vLLM+PrefixCaching | vLLM+Chunked | Mooncake vs vLLM |
|---|---|---|---|---|---|
| Conversation | 1.0 (基准) | 1.56× | 1.43× | 1.90× | -36% |
| Tool&Agent | 1.0 | 2.12× | 1.40× | 2.68× | -53% |
| Synthetic | 1.0 | 2.76× | 2.59× | 3.33× | -64% |
Synthetic 工作负载下 Mooncake 优势最大(-64%),原因正是其 最高的 prefix cache ratio(66%)+ 最长的平均输入(15325 tokens)——这正是全局缓存池最能发挥价值的场景。vLLM Prefix Caching 在 Synthetic 下几乎等效于 vLLM 基线(2.59× vs 2.76×),因为 HBM 中的本地缓存容量不足以容纳分散的热点。
9.3 全局 vs 本地缓存:命中率的差距
Figure 10: 全局缓存 vs 本地缓存的命中率(上)和平均 Prefill GPU 时间(下)。全局缓存在三种工作负载下分别实现 2.22×/1.38×/2.36× 的命中率提升,对应 24%/26%/48% 的 GPU 时间节省。
这组实验(10 个 prefill 节点,每节点 3M token 本地缓存 vs 3M token 全局共享缓存)直接回答了“分布式缓存是否值得”的问题:
- Conversation:全局缓存命中率 2.22× 本地缓存 → GPU 时间 -24%
- Tool&Agent:全局 1.38× → GPU 时间 -26%(命中率提升不大但时间节省明显——说明命中的 block 更“值钱”)
- Synthetic:全局 2.36× → GPU 时间 -48%(最大收益场景)
9.4 E2E 延迟分解:开销在哪里?
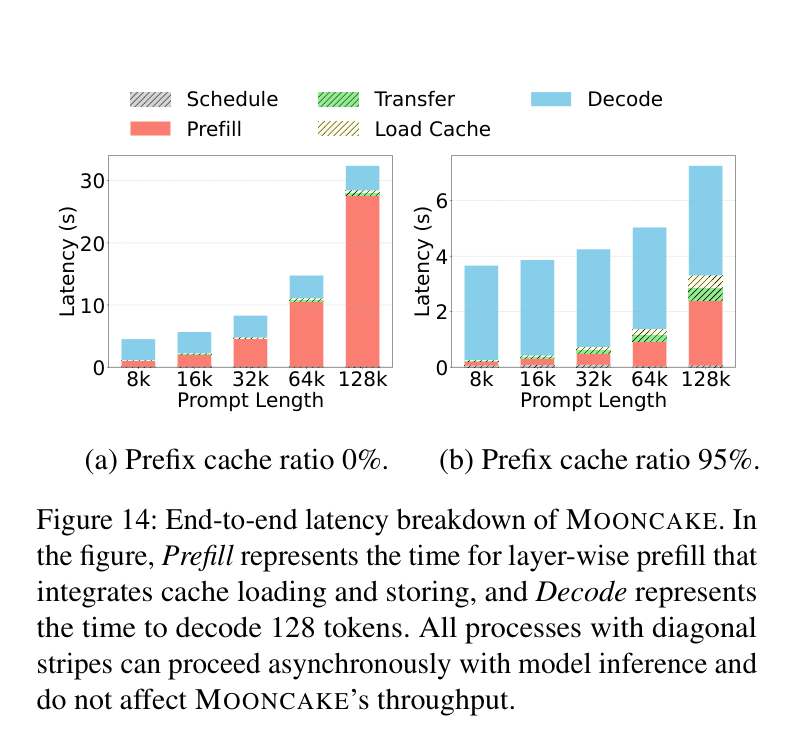
Figure 14: Mooncake 端到端延迟分解。左图为 0% prefix cache ratio,右图为 95% ratio。五种成分:Schedule(调度排队)、Prefill(层式 prefill 计算)、Transfer(KVCache 传输)、Load Cache(解码端 DRAM→HBM 加载)、Decode(128 token 解码)。带斜纹的成分可异步执行。
两组对比极其直观:
0% prefix cache(最坏情况):
- 128k tokens 的 preill 时间占主导(~25s)
- Schedule/Transfer/Load Cache 开销很小且可异步
- 总 TTFT ≈ 28s
95% prefix cache(最好情况):
- Prefill 时间骤降 92%(~25s → ~2s)!
- 即使加上 Transfer + Load Cache 的开销,总 TTFT 仍仅为 ~4s
- Prefix caching 使 TTFT 净降低 86%(128k tokens 场景)
这组数据有力地支撑了论文标题的核心主张——“Trading More Storage for Less Computation”:用更多的存储(分布式 KVCache 池)换取更少的计算(避免重复 preill),在长上下文场景下收益是数量级的。
9.5 P/D 比例:1:1 是甜蜜点
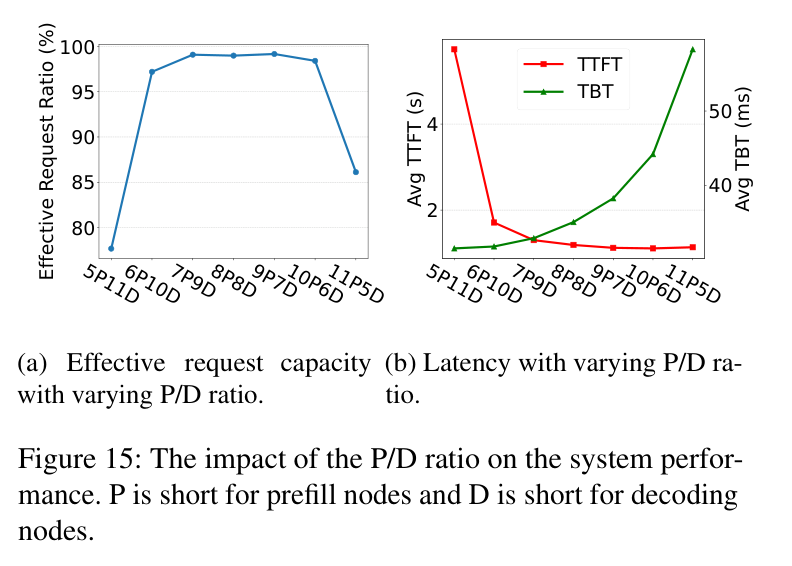
Figure 15: P/D 比例对系统性能的影响。(上)有效请求容量随 P/D 比例变化;(下)平均 TTFT 和 TBT 随 P/D 比例变化。
关键发现:
- P/D ≈ 1:1 时有效请求容量最高(~98%)
- 增加 prefill 节点 → TTFT 降低但 TBT 升高(解码 slot 竞争加剧)
- 减少 prefetch 节点 → TBT 降低但 TTFT 升高(prefill 排队加剧)
论文据此选择固定 P/D 比例(而非动态切换节点角色),理由是“online traffic statistics are generally stable”。【个人认为】这是一个务实的工程选择——动态角色切换(Splitwise/TetriInfer 提出的)理论上更灵活,但实现复杂度高且在实际流量稳定的情况下收益有限。
十、组织归因:为什么是 Moonshot AI 做出了 Mooncake?
10.1 康威定律视角
系统架构反映组织的沟通结构。Mooncake 的架构选择深刻反映了 Moonshot AI 作为一家快速增长的 MaaS 初创公司的组织约束。
Moonshot AI 控制什么?
- 模型(Kimi 系列):自有模型,可自由修改推理逻辑以适配架构
- 推理集群:自建/自运维 A800/H800 集群,可控制网络拓扑和硬件配置
- ** Serving 全栈**:从模型到调度到前端,全链路自主控制
- 用户画像:Kimi 以长上下文能力为核心卖点(200K+ token context),用户天然产生高 prefix 复用的多轮对话
Moonshot AI 依赖什么?
- GPU 供应:受制于出口管制和供应链,GPU 弹性扩容不现实(论文原文:“elastically scaling out the inference cluster is typically unfeasible”)
- 网络设备:商用 RoCEv2 交换机,无自研 NIC/交换机能力(不像 Google/Meta/AWS 可定制网络栈)
- 开源生态:深度依赖 vLLM(论文多次致谢),MOONCAKE Store 的上层语义与 vLLM 的 PagedAttention 高度兼容
10.2 设计哲学命名:“把复杂度集中在软件层”
| 决策点 | 传统方案(vLLM 等) | Mooncake | 复杂度归属变化 |
|---|---|---|---|
| KVCache 存储 | GPU HBM(本地) | 分布式 CPU DRAM 池 | 复杂度 ↑(需要传输+一致性)但容量 ↑↑ |
| 缓存复用 | 本地 HBM prefix cache | 全局 hash-based 去重 + 热点复制 | 复杂度 ↑↑(调度+迁移)但命中率 ↑↑ |
| 传输方案 | NCCL / TCP | 自研 RDMA Transfer Engine | 复杂度 ↑(自研维护)但带宽利用率 ↑↑ |
| 长上下文扩展 | SP / 弹性 SP | CPP(流水线并行) | 复杂度 ↓(无需频繁调整通信组) |
| 过载处理 | 排队/丢弃 | 预测式早拒 | 复杂度 ↑(需要预测模型)但资源效率 ↑↑ |
对偶判断:
- 凡是依赖外部的部分(GPU 供应、网络设备),Mooncake 选择最小化依赖——不自定义网络协议、不修改 RDMA 语义、不假设特殊硬件能力
- 凡是自己能控制的部分(模型、调度、缓存策略),Mooncake 把复杂度推到极致——全局调度、热点迁移、预测式早拒
这是典型的 “自给自足型”架构选择——在无法改变硬件供给的约束下,通过软件层面的极致优化榨干每一滴算力。
10.3 横向厂商对比
| 厂商 | 方案 | 核心差异 | 组织语境 |
|---|---|---|---|
| Moonshot AI (Kimi) | Mooncake | 分布式 KVCache 池 + KVCache-centric 调度 | 初创 MaaS,长上下文为核心卖点,GPU 供应紧张 |
| DeepSeek | P/D 分离(生产系统,未发论文) | 未公开分布式缓存细节,侧重 EP(Encode-Prefill-Decode)解耦 | 类似的 MaaS 定位,超长上下文(1M+ token) |
| A3+VM / TPU v5 pod | 硬件级互联(ICI 3Tbps/node),无需 RDMA 优化 | 自研芯片+网络,可以从硬件层解决带宽问题 | |
| Microsoft/Azure | DeepSpeed-FastGen / Splitwise | 侧重 goodput 优化和异构 GPU 混部 | 云厂商,关注多租户和成本优化 |
| Meta | Llama inference stacks | 内部系统未公开细节,推测侧重自家工作负载(推荐+广告) | 自有社交应用场景,workload 特征不同于通用 MaaS |
没有绝对的优劣之分。Google 可以砸钱做 ICI 互联是因为它是 Google;Moonshot AI 必须 software-defined 地榨干 RDMA 带宽是因为它买不到定制网络。各自在自己的组织约束下都是合理的。
10.4 Mooncake 丢掉了什么?
第一、多租户隔离能力。 MOONCAKE Store 的分布式缓存池是所有请求共享的,没有租户隔离机制。对于公有云多租户部署,这是一个 hard blocker。
第二、通用性牺牲。 系统为 Kimi 的工作负载特征(高 prefix 复用、长上下文、聊天场景)深度优化。对于短请求为主的场景(如代码补全、实时翻译),P/D 分离本身的 overhead 可能超过收益。
第三、运维复杂度显著增加。 P/D 分离 + 分布式缓存 + 全局调度意味着需要运维的组件数量是传统单体推理的 3-5 倍:Conductor、MOONCAKE Store Master、多个 Prefill/Decoding Instance、Transfer Engine endpoint。
第四、调试和可观测性挑战。 当一个请求的 TTFT 超时时,问题可能在 Conductor 的调度决策、Transfer Engine 的网络传输、Prefill Instance 的计算、或 Decoding Instance 的排队——排查链路显著变长。
“We also discuss how to implement a separate prefill node pool that seamlessly handles the dynamic distribution of context length.”
这话说得很自信——“seamlessly”(无缝地)。但从工程实践角度看,任何 distributed system 都不可能 truly seamless。Mooncake 团队在论文中展示了令人印象深刻的成熟度(公开 trace、开源代码、详细的 ablation study),但生产中的 corner case 一定远多于论文所能覆盖的。
十一、适用边界与行业借鉴
11.1 舒适区四条件
条件一:工作负载具有显著的 prefix 复用特征。 典型场景:多轮对话(共享 system prompt + 历史)、RAG(共享检索文档)、工具调用(共享系统指令)。如果你的请求之间几乎没有公共前缀(如实时翻译、代码补全),分布式缓存的收益会大打折扣。论文数据显示:Kimi 的 conversation workload prefix cache ratio 约 40%,tool&agent 高达 59%——这才是 Mooncake 的甜区。
条件二:长上下文占比高。 输入长度 >8k token 的请求占比越高,P/D 分离 + 全局缓存的优势越明显。论文的 synthetic workload 平均输入 15325 tokens,在这种场景下 Mooncake 比 vLLM 吞吐高 40%-62%。如果主要请求 <2k token,vLLM chunked prefill 可能就够了。
条件三:集群规模 ≥10 个 GPU 节点。 分布式缓存池需要在足够多的节点间汇聚 DRAM 才能达到 50M+ token 的容量门槛。论文分析表明:50M token 容量接近理论最大命中率,需要至少 20 个节点的 DRAM。小集群(<5 节点)的缓存池容量有限,传输开销可能抵消缓存收益。
条件四:有严格的 SLO 要求(尤其是 TBT)。 Mooncake 的核心价值是在满足 TBT SLO 的前提下最大化吞吐。如果业务对延迟不敏感(如离线批处理),传统的耦合式推理(vLLM continuous batching)可能更简单高效。
全部满足可直接借鉴;有一个不满足,就要谨慎评估。
11.2 三类不适配场景
场景一:短请求为主的实时服务(代码补全、搜索摘要)
原因是结构性的:短请求的 prefill 时间本身就很短(<10ms),P/D 分离的 KVCache 传输开销(即使只有几毫秒)可能占 prefill 时间的 30%+。而且短请求的 prefix 复用率通常很低(用户每次输入不同),分布式缓存命中率难以提升。
正确路线:使用 vLLM + chunked prefill + 本地 prefix caching 即可,无需 P/D 分离。如果追求极致低延迟,考虑 TensorRT-LLM 的 in-flight batching。
场景二:多租户公有云部署
原因是结构性的:MOONCAKE Store 无租户隔离,不同租户的 KVCache 共享同一缓存池,存在侧信道攻击风险(通过测量 cache hit/time 推断其他租户的请求内容)。此外,Master 节点的单点故障在多租户场景下影响面极大。
正确路线:使用 namespace 隔离的缓存方案(如 vLLM 的 per-instance prefix caching),或在 MOONCAKE Store 上层实现租户标签过滤(需要二次开发)。
场景三:极度成本敏感的小规模部署(<4 节点)
原因是结构性的:4 节点的 DRAM 总量 ~4TB,仅够存 ~12M token KVCache(LLaMA3-70B),距离 50M token 的“近完美命中率”容量差距甚远。此时传输开销(跨节点 RDMA + 序列化/反序列化)很可能超过缓存节省的 prefill 计算时间。
正确路线:优先考虑单机优化(FlashAttention + vLLM PagedAttention + 本地 prefix cache),在单机 HBM(80GB×8=640GB)充分利用后再考虑横向扩展。
11.3 分群体建议
面向超大型云厂商(阿里云、腾讯云、AWS 中国):
- 第一,评估将 MOONCAKE Store 的 Transfer Engine 作为底层传输组件集成到自有 MaaS 平台的可行性。其多网卡 RDMA 聚合能力和拓扑感知选路是通用的,不依赖于 Mooncake 的调度逻辑。
- 第二,关注 Mooncake 的 overload-oriented scheduling 经验。随着大模型 API 的普及,过载将是所有 MaaS 提供商的日常,预测式早拒 + 负载平滑是必备能力。
- 第三,等待 MOONCAKE Store 的多租户隔离特性成熟后再考虑整体引入。当前版本的隔离能力不足以满足公有云合规要求。
面向 AI 头部公司(字节、百度、智谱等):
- 第一,立即评估自身工作负载的 prefix cache ratio。如果在 30% 以上且有长上下文需求,P/D 分离 + 分布式缓存的 ROI 会非常可观。
- 第二,如果已在用 vLLM,可以渐进式接入:先集成 Transfer Engine 做 P/D 分离的 KVCache 传输(vLLM 已官方支持 Mooncake Connector),再考虑 MOONCAKE Store 替代本地 prefix cache。
- 第三,重点关注 CPP 机制。如果你也在面临长上下文(>32k token)preill 的 TTFT 压力,CPP 比 SP 更容易集成到现有系统中。
面向传统行业自建集群(金融、运营商、能源):
- 第一,不要从 Mooncake 开始。先确保 vLLM + chunked prefill + 本地 prefix caching 在你的工作负载上跑出基线数据。
- 第二,如果你的集群规模 <10 个节点且 GPU 型号 ≤A800,优先投资 GPU 而非架构创新。A800 的 inter-connect 带宽(200Gbps/NIC × 4 = 800Gbps/node)可能成为 KVCache 传输的瓶颈。
- 第三,把 Mooncase 作为“架构参考”而非“实施方案”。学习它以 KVCache 为调度核心的思想,用自己的技术栈(可能是基于 Ray + Redis 的简化版)实现一个轻量变种。
十二、结语
Mooncake 不是终点,是一个里程碑。它真正的价值不在于 MOONCAKE Store 或 Transfer Engine 这些具体组件有多创新,而在于它向行业证明了:在 GPU 供给受限的前提下,用存储换算力、以 KVCache 为调度中枢的解耦架构,是能够带来质变的可行方向。
国内同行学 Mooncake,不是要照搬它的 MOONCAKE Store 实现、不是要抄它的 Transfer Engine 拓扑矩阵格式、不是要复刻它的 CPP pipeline 划分策略——而是要学它 “在正确的层次上做优化” 的工程直觉:当算力无法扩充时,从系统中找到被浪费的资源(CPU/DRAM/SSD/NIC)并把它们组织起来服务于瓶颈(KVCache 复用);当传统调度指标(队列深度、GPU 利用率)不再能反映用户体验时,定义新的 metric(goodput = 满足 SLO 的有效吞吐);当学术界假设资源无限时,直面过载并设计与之共存的调度策略。
Mooncake 拿到了 FAST’25 最佳论文,其 Transfer Engine 被 vLLM/SGLang/TensorRT-LLM/LMCache 等主流框架集成,MOONCAKE Store 成为 PyTorch 生态的一部分——这些生态认同比论文中的任何一个数字都更能说明问题的分量。
但任何技术方案的合理性都和它所在的组织语境强绑定。下一个问题永远是:“我所在的团队,约束条件和 Moonshot AI 一样吗?”
这个哲学,比任何具体协议都重要。
参考材料
- Ruoyu Qin, Zheming Li, Weiran He, et al. Mooncake: Trading More Storage for Less Computation — A KVCache-centric Architecture for Serving LLM Chatbot. USENIX FAST ’25, February 2025. https://www.usenix.org/system/files/fast25-qin.pdf
- Ruoyu Qin, Zheming Li, Weiran He, et al. Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving. arXiv:2407.00079v4, September 2025. https://arxiv.org/abs/2407.00079
- Mooncake Official Documentation. https://kvcache-ai.github.io/Mooncake/
- Mooncake Open Source Repository. https://github.com/kvcache-ai/Mooncake
- Pratyush Patel, et al. Splitwise: Efficient Generative LLM Inference Using Phase Splitting. ISCA ’24, 2024.
- Yinmin Zhong, et al. DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving. OSDI ’24, 2024.
- Cunchen Hu, et al. Inference Without Interference: Disaggregate LLM Inference for Mixed Downstream Workloads. arXiv:2401.11181, 2024.
- Amey Agrawal, et al. Sarathi-Serve: Taming Throughput-Latency Tradeoff in LLM Inference. OSDI ’24, 2024.
- Woosuk Kwon, et al. Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP ’23, 2023. (vLLM)
- Lianmin Zheng, et al. SGLang: Efficiently Programming Large Language Models with RadixAttention. arXiv:2312.07104, 2023.
- Yazhuo Zhang, et al. SIEVE: Simpler Than LRU – An Efficient Turn-key Eviction Algorithm for Web Caches. NSDI ’24, 2024.
- Bin Gao, et al. CachedAttention: Cost-efficient Large Language Model Serving for Multi-turn Conversations. USENIX ATC ’24, 2024.
术语表
Mooncake:Moonshot AI(月之暗面)开发的 KVCache 中心化解耦 LLM 推理架构,是 Kimi 聊机器人的生产服务平台。本文分析的对象,FAST’25 最佳论文。
KVCache(Key-Value Cache):Transformer 推理过程中 attention 层计算的中间结果(每个 token 的 Key 和 Value 向量),在 autoregressive 生成中被反复读取。是 LLM 推理中除模型权重外最大的内存消费者,也是 Mooncake 架构围绕的核心对象。
P/D 分离(Prefill/Decode Disaggregation):将 LLM 推理的两个阶段——Prefill(处理全部输入 token,计算密集)和 Decode(逐 token 生成,内存带宽密集)——分配到不同 GPU 节点上执行,消除相互干扰。代表性系统:Splitwise(ISCA’24)、DistServe(OSDI’24)。
MOONCAKE Store:Mooncake 的分布式 KVCache 存储引擎,聚合集群中各节点的 CPU/DRAM/SSD 资源形成跨节点共享的缓存池。提供 Put/Get/Remove 等对象级 API,支持多副本、LRU 淘汰、租约机制。已开源。
Transfer Engine:Mooncake 自研的高性能数据传输引擎,基于 RDMA 实现 GPU/DRAM 间的零拷贝传输。核心能力:拓扑感知路径选择、SIEVE 端点池化、多网卡切片聚合、故障自动切换。已独立开源并被 vLLM/SGLang/TensorRT-LLM 集成。
Conductor:Mooncake 的全局调度器,负责任务的路由决策。包含两个子组件:KVCache-centric Conductor(cache-aware prefill 调度)和 KVCache Balance Scheduler(热点缓存迁移均衡)。
CPP(Chunked Pipeline Parallelism):Mooncake 提出的长上下文 prefill 并行化方法。将 prefill 阶段按 layer 切分为多个 chunk,在不同节点上流水线式处理。首次将训练系统的 Pipeline Parallelism 引入推理阶段。
Layer-wise Prefill:每完成一层模型的 attention 计算,就异步将该层的 KVCache 存回 CPU 内存(store)并预取下一层的 KVCache(load),使传输/存储与计算完全重叠。
TTFT(Time to First Token):从请求到达系统到生成第一个 token 的延迟。Prefill 阶段的主要优化目标,直接影响用户感知的“响应速度”。
TBT(Time Between Tokens):解码阶段相邻两个 token 生成之间的间隔时间。Decode 阶段的主要优化目标,影响用户感知的“流式体验流畅度”。
Goodput:在满足 SLO 约束下的有效系统吞吐(满足 TTFT 和 TBT 阈值的请求数/秒)。区别于 raw throughput(不考虑 SLO 的绝对吞吐),DistServe 和 Mooncake 均采用此指标。
SLO(Service Level Objective):服务等级目标。Mooncake 场景下主要为 TTFT_SLO(如 30s)和 TBT_SLO(如 100ms/200ms/300ms),以 P90 或固定阈值形式表达。
Prefix Caching / RadixAttention:利用 Transformer 的自回归特性,对不同请求间的公共前缀(如 system prompt、对话历史)的 KVCache 进行复用,避免重复计算。vLLM 基于 block hash 实现,SGLang 基于 radix tree 实现(RadixAttention)。
Early Rejection(早拒):在请求进入 prefill 之前就预测其是否能获得满足 SLO 的 decoding 资源,若不能则直接返回 HTTP 429 拒绝,节省无效的 prefill 计算资源。P/D 分解耦系统特有问题。
Overload-oriented Scheduling(过载导向调度):Mooncake 在 arXiv 版本中重点讨论的调度范式,针对 MaaS 场景下 GPU 供给不足导致的常态化过载,结合预测模型实现更智能的请求接纳/拒绝决策。
GPUDirect RDMA:NVIDIA 技术,允许 GPU 通过 PCIe 直接与 NIC 交互进行 RDMA 读写,绕过 CPU 主内存,实现 GPU VRAM 与远程节点 DRAM 间的零拷贝传输。
Topology-aware Path Selection:Transfer Engine 的核心能力之一。根据服务器内部的 NUMA/PCIe 拓扑结构(CPU Socket ↔ PCIe Switch ↔ NIC 的连接关系),为每次传输选择最优的源/目标 NIC 组合,最小化路径开销。
SIEVE:一种 Web 缓存淘汰算法(NSDI’24, Zhang et al.),被 Mooncake 用于 RDMA Endpoint 池的管理。相比 LRU,SIEVE 在动态工作负载下具有更低的开销和更好的命中率。
PagedAttention:vLLM 核心创新(SOSP’23),将 KVCache 按固定大小的 page(block)管理,类似操作系统的虚拟内存分页,解决了 KVCache 碎片化问题。Mooncake 的 KVCache block 存储在此基础上扩展到跨节点。
Hash-based Deduplication(哈希去重):Mooncake 对 KVCache block 的去重方式。每个 block 的 key 由其自身 token 内容的 hash 加上前序 block 的 hash 共同确定(rolling hash / Merkle-like 结构),保证相同前缀的内容自动映射到同一缓存块。
Hotspot Migration(热点迁移):MOONCAKE Store 的缓存均衡机制。通过 Conductor 的调度决策副作用(将请求路由到非最佳缓存节点时主动拉取缓存)自动完成热点 block 的多副本复制,无需独立的预测式预复制模块。
RoCEv2(RDMA over Converged Ethernet v2):Mooncake 使用的 RDMA 传输协议,运行在标准以太网上,通过云厂商(如阿里云)的 PFC/ECN 配置优化拥塞控制。区别于需要专用 InfiniBand 网络的 native RDMA。
MFU(Model FLOPs Utilization):模型浮点运算利用率,实际达到的 FLOPS 占理论峰值的比例。Prefill 阶段通常较高(compute-bound),Decode 阶段较低(memory-bound)。Mooncake 的 CPP 目标是提高长上下文 prefill 的 MFU。
Sequence Parallelism(SP,序列并行):将输入序列切分到不同节点上并行处理的方法(Ring Attention / Striped Attention 等)。Mooncake 评估后选择 CPP 而非 SP,原因是 SP 的频繁跨节点通信降低 MFU 且与 KVCache 传输争抢网络。
vLLM:UC Berkeley/SME 开源的高吞吐 LLM 推理系统,目前的事实标准。Mooncake 的实验基线,也是 MOONCAKE Store/Transfer Engine 的主要集成目标(vLLM 官方 Mooncake Connector)。
Kimi:Moonshot AI(月之暗面)开发的大语言模型聊天机器人产品,以长上下文处理能力为核心卖点(200K+ token context window)。Mooncake 是其生产推理平台。