DualPath 深度解读:当“空闲的另一半网卡”成为破局点
从双路径 KV-Cache 加载、CNIC 流量管理到自适应调度,理解推理系统如何把闲置网络带宽重新变成有效吞吐。
论文:DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference(Yongtong Wu, Shaoyuan Chen, Yinmin Zhong 等,北京大学 / 清华大学 / DeepSeek-AI,arXiv:2602.21548,2026-02)
信息来源层级:本文技术细节以 arXiv HTML 全文(v1)为一手来源,量化数据逐一核对论文正文与图表;技术溯源、组织背景部分标注了公开资料出处;凡属笔者判断处均显式标注“个人认为”/【推测】。
TL;DR
1、DualPath 不是一次协议或算法创新,而是对 PD 分离架构里“结构性带宽浪费”的一次系统级纠偏
它的贡献不在发明新机制,而在于点破了一个被行业默认已久的浪费:在 Prefill–Decode 分离(PD-disaggregated)推理架构里,所有从外部存储加载 KV-Cache 的 I/O 压力都压在 Prefill 引擎(PE)的存储网卡(SNIC)上,而 Decode 引擎(DE)的存储网卡几乎全程空闲。DualPath 用三根支柱把这半张闲置网卡“偷”回来:双路径加载(Dual-Path Loading)、以计算网卡为中心的流量管理(CNIC-Centric Traffic Manager)、自适应请求调度(Adaptive Request Scheduler)。
2、双路径加载:新增一条“存储→解码引擎”反向路径,把全集群网卡聚成一个带宽池
传统只有 storage→prefill 一条路;DualPath 增开 storage→decode 一条,KV-Cache 先落到 DE 的 DRAM buffer,再经计算网 RDMA 高带宽回传给 PE。两条路径的负载由调度器动态分配,等效于把 PE 与 DE 的存储带宽合并成一个全局池。论文用分析模型证明:在典型配置(每节点 g=8 GPU、s=1 存储网卡、内存带宽 M≈500 GB/s、存储带宽 Bs≈50 GB/s)下,只要 1/7 ≤ P/D ≤ 7/2,系统就是“无瓶颈”的——覆盖了绝大多数实际部署。
3、CNIC 中心流量管理:把存储流量塞进计算网,用 InfiniBand 虚拟通道 QoS 做隔离
反向路径要借用计算网 RDMA,这就冒了“污染延迟敏感的模型通信”的风险。DualPath 的解法是让所有 GPU 相关流量(含本地内存拷贝)统一走 CNIC 的 GPUDirect RDMA,用 IB 的 Virtual Lane + 加权轮询(WRR),给模型通信保留约 99% 的高优先级带宽,KV-Cache 传输只吃闲带宽。它还发现一个反直觉的工程细节:cudaMemcpyAsync 的本地拷贝延迟约 5–7 μs,而一次 RDMA Write 仅约 1 μs,于是干脆连本地 H2D 拷贝也改走 CNIC。
4、实测收益扎实但不夸张:离线吞吐最高 1.87×,在线服务平均 1.96×,且不违反 SLO
在 1152 GPU 的生产集群上、三个模型(DS 660B / DS 27B / Qwen2.5-32B)、三份真实 agent trace 上评估。消融实验很诚实地把功劳拆开:层化 prefill 单独降 JCT 17.21%,加双路径累计 38.19%,再加调度器累计 45.62%。大规模在线场景下吞吐可达 22×(8.8 vs 0.4 APS),调度器 CPU 占用 <10 核。
5、方案有清晰舒适区,盲目照搬会踩坑
DualPath 吃的是“长上下文、短追加、高命中率(≥95%)“这口饭。一旦 append 变长、GPU 算力重新成为瓶颈,它的优势就迅速收窄(论文自陈:append 长度扩到 3× 时,Basic 已逼近 Oracle)。它还给 DE 增加了 DRAM 压力和额外 PCIe 流量;CNIC 中转相比 GPUDirect Storage 有一小段绕路,对 PCIe 本就吃紧的小模型未必划算。更关键的是,它是 DeepSeek 全栈自控(自研模型 + 推理引擎 + 3FS 存储 + 计算网)语境下的产物——学它的哲学(“把结构性闲置的资源变成可调度的池”)远比抄它的实现重要。
引言:瓶颈已经悄悄从“算力”搬到了“存储带宽”
DualPath 不应被简单理解为“又一个 KV-Cache 缓存优化”。更准确地说,它是对 agentic 推理时代 I/O 瓶颈本质的一次重新定性,以及针对 PD 分离架构结构性缺陷的一次外科手术式修补。
过去两年,LLM 推理系统的优化叙事一直围绕“算力”和“显存”打转:如何把 GPU 的 tensor core 喂饱、如何用 PagedAttention 省显存、如何用 chunked prefill 削平首 token 延迟。但 agentic(智能体)范式的兴起,把矛盾悄悄换了地方。一个 coding agent 或 autonomous task agent,会在一个长会话里和外部环境(浏览器、Python 解释器、工具调用)交互几十上百轮。每一轮工具返回的 token 很短(几百个),但上下文像滚雪球一样越滚越大——论文实测的一份 64K trace,平均 157 轮、平均上下文 32721 token、每轮平均只追加(append)429 token。
这个“长上下文、短追加”的形态,带来一个决定性后果:KV-Cache 命中率高达 98.7%。既然 98.7% 的 KV-Cache 都能复用,那系统性能的决定性因素就不再是“算得多快”,而是“从存储里把 KV-Cache 拉过来有多快”。工作负载从 compute-bound 彻底翻转成了 I/O-bound。
而恰恰在这个节骨眼上,主流的 PD 分离架构暴露了一个长期被忽视的结构性浪费。本文将围绕以下三个核心技术支柱展开拆解,并在最后讨论它的组织归因与适用边界:
- 双路径加载(Dual-Path Loading):新增 storage→decode 反向路径,把 PE、DE 两侧的存储网卡合并成一个全局带宽池,这是全篇的灵魂机制;
- CNIC 中心流量管理(CNIC-Centric Traffic Manager):让存储流量借道计算网,靠 IB 虚拟通道 QoS 与延迟敏感的模型通信互不干扰;
- 自适应请求调度(Adaptive Request Scheduler):实时感知各引擎的读队列与算力负载,为每个请求动态选路、组批,把双路径的理论带宽真正兑现成吞吐。
拆完这三根支柱,我们再回答两个更有意思的问题:为什么是 DeepSeek + 北大 + 清华这个组合做出了 DualPath?以及——你所在的组织,能照抄它吗?
一、瓶颈的解剖:一半网卡饱和,另一半在睡觉
在拆解方案之前,必须先把“病灶”看清楚。这是 DualPath 全部设计的出发点,也是论文 Fig.1 想一眼讲清的事。
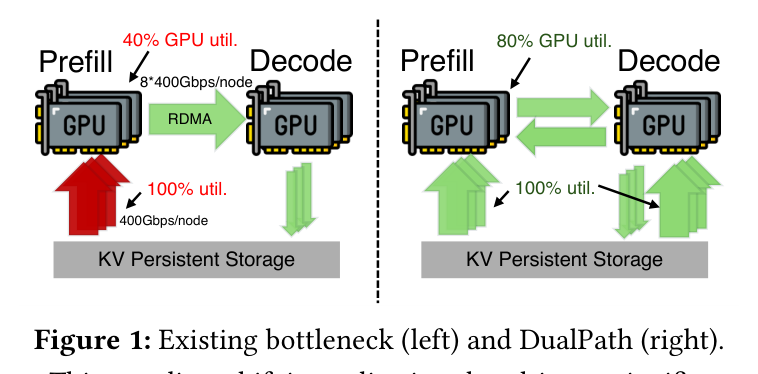
这张图画了什么:左半边是现状——所有 KV-Cache 都从分布式存储(3FS)经 Prefill 引擎的存储网卡(SNIC)读入,PE 的 SNIC 被打满(图中标红/饱和),而 Decode 引擎的 SNIC 一侧几乎没有流量箭头,处于闲置。右半边是 DualPath——在保留 storage→PE 原路径的同时,新增一条 storage→DE 的加载路径,DE 读入的 KV-Cache 再经计算网 RDMA 回传 PE,两侧网卡都被利用起来。关键路径在于右图那条新增的、从 DE 指回 PE 的箭头:它就是全篇的“第二条腿”。它支撑的论点是:瓶颈不是“总带宽不够”,而是“带宽分配不均”——把闲置的一半用起来,等于免费扩容一倍存储带宽。
为什么这个失衡是结构性的、而非偶发的?论文给出了三重根因:
第一,agentic 负载的高命中率,把 I/O 顶成了第一矛盾。 缓存-计算比(cache-compute ratio,即每 PFLOP 计算需要搬运多少 GB 的 KV-Cache)在长上下文下急剧升高。论文 Table 1 给出一组冷峻的数字(append 长度固定 429,上下文 16K→64K):
| 模型 | 缓存-计算比(GB/PFLOP,16K→64K) |
|---|---|
| Qwen2.5-32B (FP16) | 117 → 267 |
| GPT-OSS-120B | 47 → 95 |
| Qwen3-235B-A22B | 39 → 60 |
| DeepSeek-V3.2 660B | 13 → 36 |
| DeepSeek-V3 660B | 4.8 → 5.8 |
这张表本身就藏着一个耐人寻味的信号:采用 MLA(Multi-head Latent Attention)的 DeepSeek 系列,缓存-计算比是全表最低的(DS-V3 仅 4.8–5.8)。也就是说,DeepSeek 自家模型的 KV-Cache 已经被架构性地压到极小了,可即便如此,在 agentic 场景下它依然会撞上存储带宽的墙——这从侧面说明这个 I/O 瓶颈有多硬。反过来看 Qwen2.5-32B(FP16、MHA),缓存-计算比高达 267,存储 I/O 的压力是 DS-V3 的近 50 倍。
第二,硬件趋势在火上浇油。 GPU 的算力增长远快于 I/O 带宽增长。论文 Fig.3 给出了从 Ampere 到 Blackwell 的对照。
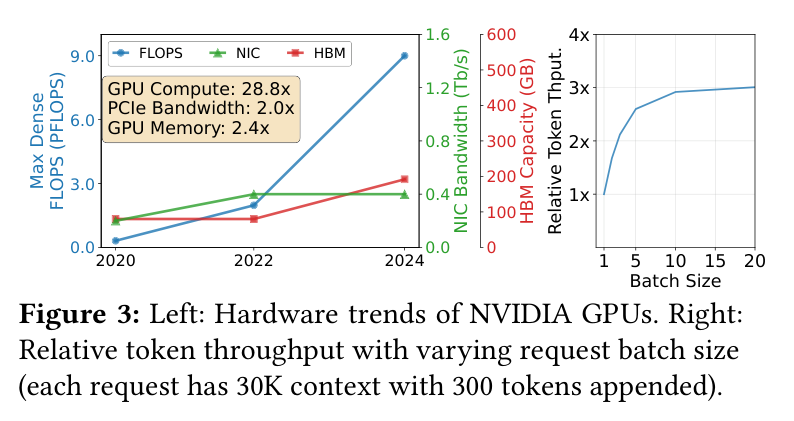
这张图画了什么:左图是 NVIDIA 历代 GPU 的算力(FLOPS)、显存带宽、HBM 容量的相对增长曲线;右图是固定 30K 上下文 + 300 token 追加时,相对 token 吞吐随 batch size 的变化。关键数据点:论文明确指出,从 Ampere 到 Blackwell,I/O-计算比下降了 14.4×——通俗说,同样一份计算,能分到的 I/O 带宽只剩十四分之一。它支撑的论点是:这不是一代硬件的偶然,而是一个持续恶化的长期趋势;靠“等下一代硬件”解决 I/O 瓶颈是没指望的,必须在系统层面动手。
第三,也是最直接的——存储网络利用率的极度不均衡。 在现有 PD 分离 + 外部 KV-Cache 存储的架构里,PE 负责从存储加载海量历史 KV-Cache,它的 SNIC 持续饱和;DE 只负责生成,它的 SNIC 只在把新生成的 KV-Cache 落盘时用一下,绝大部分时间闲着。给 PE 单独加带宽?在通用集群里既贵又不现实(存储网卡数量、PCIe 通道、机架供电都是约束)。于是论文抛出那句朴素但关键的判断:
“Therefore, it is promising to exploit and combine the available I/O bandwidth of all engines, rather than overloading prefill engines alone, to accelerate KV-Cache loading for agentic LLM workloads.”
这话说得平实,但它其实推翻了一个隐含假设——KV-Cache 的加载“必须”以 prefill 为中心。一旦承认“加载不必只走 PE”,storage→decode 这条反向路径的合法性就成立了。DualPath 的全部精巧,都是从松开这个假设开始的。
至于既有工作为什么没解决这个问题,论文也点了名。**Mooncake(Qin et al., 2024)**把 KV-Cache 缓存进分布式 DRAM 池,用 affinity-aware 调度提高 DRAM 命中率——但它在内存受限场景(如 RL rollout 阶段,DRAM 被从 HBM offload 下来的训练状态占满)用不了,且在超大工作集(在线服务)下,DRAM 相比 SSD 的成本劣势明显。其它工作(减少要拉取的 KV-Cache 数据量、降低检索开销)则都没触及“引擎间存储 I/O 不均衡”这个根子上的低效。
一句话总结病灶:闲置即浪费,浪费即瓶颈。 DualPath 要做的,就是把那半张睡着的网卡叫醒。
二、双路径加载:给 KV-Cache 修一条“逆行车道”
这是全篇最核心、也是最优雅的机制。我们直接看论文 Fig.4。
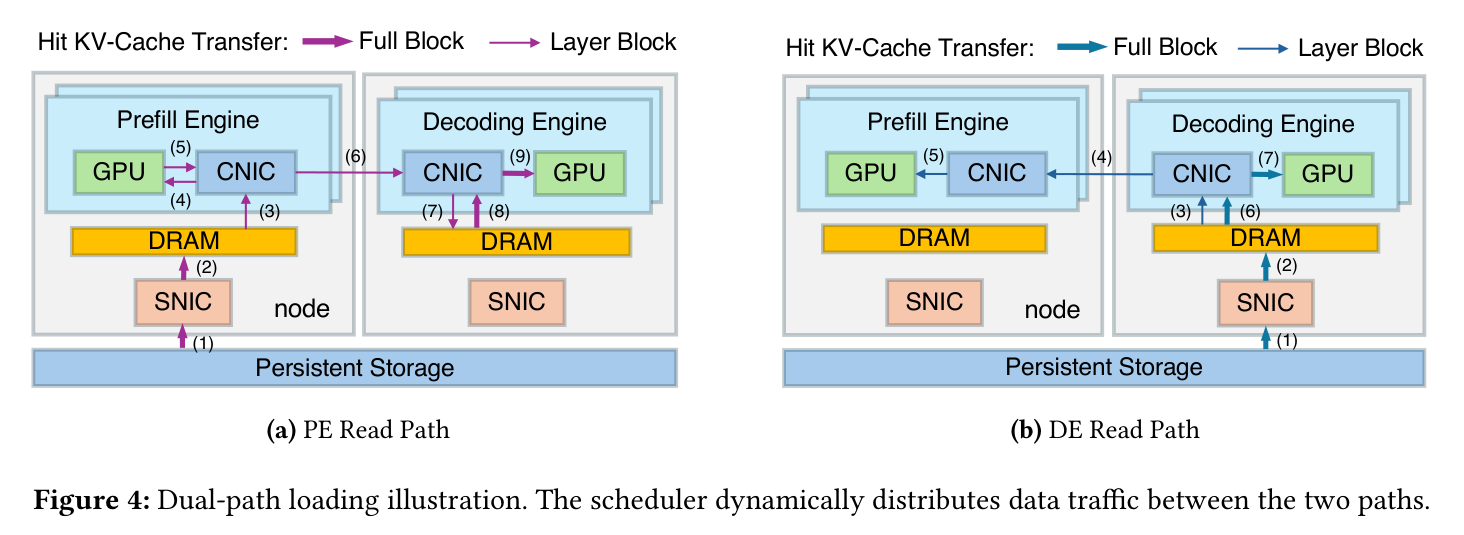
这张图画了什么:图分 (a)(b) 两条路径。(a) PE Read Path(传统路径):KV-Cache 从存储读入 PE 的 DRAM buffer → 按层前传(layer-wise)到 PE 的 HBM 参与 prefill 计算 → prefill 完成后,完整 KV-Cache 经计算网 RDMA 传给 DE 的 buffer,供解码。(b) DE Read Path(新增反向路径):KV-Cache 先直接读入 DE 的 DRAM buffer → 在 PE 做 prefill 计算时,按层从 DE buffer 经 RDMA 拉到 PE HBM(缺失的部分现算,算完再传回 DE buffer 合并)→ 最终 DE 手里攒齐完整 KV-Cache,直接启动解码。关键路径是 (b) 中那条 “DE buffer → PE HBM” 的层级流式传输箭头。它支撑的论点是:同一份 KV-Cache,既可以走 PE 的存储网卡进来,也可以走 DE 的存储网卡进来——加载入口从“单口”变成了“双口”。
2.1 机制拆解:两条路径如何拼成一个带宽池
把两条路径并排看,你会发现它们的差异只在“KV-Cache 第一站落在谁的 DRAM”:
- PE Read Path:存储 → PE buffer → PE HBM(层流)→ DE buffer。吃的是 PE 侧 SNIC 带宽。
- DE Read Path:存储 → DE buffer → PE HBM(层流,经计算网 RDMA)→ 算完回填 DE buffer。吃的是 DE 侧 SNIC 带宽 + 计算网带宽。
调度器按两侧存储网卡的实时队列长度,动态决定每个请求(甚至每个 block)走哪条路。当 PE 侧饱和、DE 侧空闲时,就把更多流量推向 DE Read Path。两侧 SNIC 的带宽被逻辑上合并成一个全局池,这就是“带宽资源池化”的实质。
这里有个容易被忽略的工程设计:Block 的双布局。KV-Cache 在存储里以 Full Block(含所有层,用于与存储交互)组织,而在 PE HBM 与 DE buffer 之间的层间流式传输,则用 Layer Block(单层粒度)。之所以要两种布局,是因为存储 I/O 喜欢大块顺序读(Full Block 更高效),而层化 prefill 需要单层粒度的细流水(Layer Block 才能和逐层计算重叠)。一个机制里塞进两种数据布局来分别迎合“存储侧的吞吐偏好”和“计算侧的流水偏好”,是内行才会较真的细节。
打个比方:传统架构像一条只有 PE 侧一个收费站的高速入口,车(KV-Cache)全堵在那;DualPath 在对面 DE 侧又开了一个收费站,还修了一条计算网 RDMA 的“逆行车道”把从 DE 进来的车导回 PE。 收费站从一个变两个,通行能力理论上翻倍。
2.2 无瓶颈分析:一个把“什么时候有效”讲清楚的公式
论文最让我欣赏的一点,是它没有停留在“我加了条路,快了”,而是给出了一个分析模型,精确回答“在什么 P/D 配比下,双路径能做到既不浪费也不成为新瓶颈”。
设 P 为 PE 节点数、D 为 DE 节点数,每节点 g 个 GPU、s 张存储网卡,每 GPU 计算网卡带宽 B、内存带宽 M、存储带宽 Bs。论文对 PCIe、CNIC、DRAM 三处压力逐一建模,推导出“无瓶颈”(bottleneck-free)成立的充要区间:
$$\frac{s}{g-s} \le \frac{P}{D} \le \min\left{\frac{g-2s}{s},\ \frac{g-s}{2s},\ \frac{M/Bs-3}{2}\right}$$
代入典型生产配置(g=8、s=1、M≈500 GB/s、Bs≈50 GB/s),解得:
$$\boxed{\ \frac{1}{7} \le \frac{P}{D} \le \frac{7}{2}\ }$$
这个区间的意义非同小可:它意味着从 1 台 PE 配 7 台 DE,到 7 台 PE 配 2 台 DE,DualPath 都能做到无瓶颈。绝大多数真实部署的 P/D 配比(论文实验用的 2P4D、1P2D、1P1D 全在区间内)都落在这个舒适区里。这就把“这方法到底什么时候管用”从玄学变成了可计算的工程判据——这是分析模型的价值,也是我个人认为它比很多“炼丹式”系统论文更扎实的地方。
2.3 “双路径不是免费的”
天下没有免费的午餐。这条逆行车道,代价藏在几个地方:
- 第一,DE 的 DRAM 压力陡增。 DE 现在要为 DE Read Path 维护一块 buffer 来暂存拉进来的 KV-Cache,这在 RL rollout 等 DRAM 本就被训练状态占满的场景里,会直接和训练抢内存。论文自己在 Discussion 里承认这是 DualPath 增加 DRAM 压力的来源之一。
- 第二,额外的 PCIe 流量。 KV-Cache 经 DE buffer 中转,比直接 GPUDirect Storage 进 HBM 多走了一趟 DRAM,PCIe 上多了一份来回搬运。对 PCIe 带宽本就吃紧的小模型,这份 overhead 未必可忽略——这是论文 Practical Notes 里点名的局限。
- 第三,计算网被“借用”。 反向路径要占用计算网 RDMA 带宽。计算网是给 all-reduce / all-to-all 这类延迟敏感的模型通信用的,KV-Cache 这种大流量一旦没管好,就会污染模型执行。这个代价大到需要单独一根支柱(CNIC 流量管理)来兜底——正是下一节的主题。
- 第四,两条路径的正确性协调更复杂。 DE Read Path 里“缺失部分现算、算完回填合并”的逻辑,意味着一份 KV-Cache 可能同时存在于 DE buffer 和 PE HBM,需要保证层级一致性与合并正确性。这部分工程复杂度,是双路径相对单路径实打实多出来的。
2.4 技术溯源:DualPath 站在谁的肩膀上
DualPath 的每一块地基,几乎都能在既有工作里找到出处。这不是贬低——恰恰是系统论文的常态:真正的增量往往是“整合 + 规模验证”,而非单点发明。
| 特性 / 机制 | 最早出处(论文 + 年份) |
|---|---|
| PD 分离(Prefill–Decode Disaggregation) | DistServe(OSDI 2024)、Splitwise(ISCA 2024) |
| 层化 prefill(Layer-wise Prefill) | LayerKV(2024)、PrefillOnly(Du et al., 2025) |
| 外部 KV-Cache 存储 / 分布式缓存池 | Mooncake(arXiv 2407.00079, 2024;FAST 2025 最佳论文) |
| 基于 RDMA 的跨节点 KV 传输 | Mooncake Transfer Engine(2024)、DistServe(2024) |
| KV-Cache 复用 / 前缀缓存 | vLLM PagedAttention(2023)、SGLang RadixAttention(MLSys 2025) |
| 计算网 GPUDirect RDMA | NVIDIA GPUDirect RDMA(2013 起) |
| InfiniBand 虚拟通道(VL)+ WRR QoS | InfiniBand Architecture Spec(IBTA,2000 年代起) |
| 分布式文件系统后端 | 3FS / Fire-Flyer File System(DeepSeek,2025 开源) |
表看下来,结论很清楚:PD 分离、层化 prefill、外部存储、RDMA 传输、VL QoS——没有一样是 DualPath 发明的。 它真正的、也是唯一的原创点,是那条 storage→decode 反向路径 + 全局带宽池化的洞察,以及围绕它把上述已有积木重新拼装、并在 1152 GPU 生产集群上跑通验证。
有意思的是,PD 分离的鼻祖 DistServe 的第一作者仲殷旻(Yinmin Zhong),正是 DualPath 的共同作者之一。换句话说,是同一批人(北大金鑫组),先在 2024 年把 prefill 和 decode 拆开,两年后又回来给这个自己创造的架构补上了“带宽不均衡”这个后遗症的补丁。 这条技术传承线,我们在组织归因一节还会再提。
三、CNIC 中心流量管理:把存储流量“塞进”计算网还不添乱
双路径最大的风险,上一节已经点出:DE Read Path 要借用计算网 RDMA 回传 KV-Cache,而计算网上跑的是延迟极其敏感的模型通信(tensor/expert parallelism 的 all-reduce、all-to-all)。KV-Cache 是“大象”,模型通信是“绣花”——让大象和绣花共用一条网,稍不留神就把绣花踩了。 这一节讲 DualPath 怎么让大象走得又快又不碰绣花。
论文摘要对这条路径的措辞是这样的:
“DualPath combines this optimized data path — which inherently avoids network congestion and avoids interference with latency-critical model execution communications — with a global scheduler that dynamically balances load across prefill and decode engines.”
这句话里 “inherently avoids(天然避免)“这个词用得有点漂亮过头了。稍微熟悉网络 QoS 的读者都知道:一条借道计算网的大流量路径,绝不会”天然“就不干扰模型通信——恰恰相反,它天然就是威胁。 真正让它”无害“的,不是数据路径本身,而是接下来要讲的 VL + WRR 那套精心配置的隔离机制。把”靠 QoS 配置换来的隔离“说成”路径天然如此“,是论文在推销自己设计时的一点小小的话术——但也恰好说明,这套流量管理才是让双路径能成立的真正地基。
3.1 流量隔离:InfiniBand 虚拟通道 + 加权轮询
核心做法是:让所有 GPU 进出的流量(包括本地内存拷贝)统一经过配对 CNIC 的 GPUDirect RDMA,然后用 InfiniBand 的 Virtual Lane(VL,虚拟通道) 做优先级隔离:
- 高优先级 VL → 模型执行通信(all-reduce / all-to-all 等);
- 低优先级 VL → KV-Cache 传输(双路径的反向流量)。
交换机与网卡按 加权轮询(Weighted Round Robin, WRR) 在两条 VL 间分配带宽,权重配置为给高优先级保留约 99% 的带宽。这样 KV-Cache 流量只在模型通信空闲时“捡漏”吃闲带宽,几乎不侵占延迟敏感流量的份额。论文附录 A.1 甚至给出了可复现的 IB 配置参数:qos_max_vls 4、qos_high_limit 240、qos_vlarb_high 0:192,1:192,2:0,3:192、qos_vlarb_low 0:192,1:192,2:64,3:192——这种把生产配置直接贴出来的坦诚,对想复现的工程师是实打实的福利。(在 RoCE 网络上,等价能力可用 TC/DSCP 实现。)
这套设计的精髓在于:它没有为存储流量单独建网,而是承认“计算网大部分时间没打满”,用 QoS 把闲带宽安全地让渡出来。 这又是一次“把结构性闲置的资源变成可调度的池”——和双路径偷网卡带宽是同一种哲学,只不过这次偷的是计算网的闲带宽。
3.2 一个反直觉的细节:连本地拷贝都改走网卡
这是我在全篇里最喜欢的一个工程 insight。常识里,“本地 H2D 拷贝”(把数据从主机 DRAM 搬到本机 GPU HBM)用 cudaMemcpyAsync 天经地义。但论文实测发现:
cudaMemcpyAsync的单次拷贝延迟约 5–7 μs;- 一次 RDMA Write 仅约 1 μs,而且可以用 doorbell batching 把发起开销摊薄。
于是 DualPath 干脆把 KV-Cache 的本地 H2D 拷贝也改成“先读到主机 DRAM,再用 CNIC 的 RDMA Write 写进 GPU”。一个本该用 CUDA API 解决的本地问题,用网卡解决反而更快 ——这听起来违反直觉,但背后逻辑是:现代 CNIC 的 GPUDirect 路径经过高度优化,其发起延迟已经低于 CUDA runtime 的拷贝调用开销。把所有 GPU 流量(远程 + 本地)统一收敛到 CNIC,既拿到了延迟收益,又让 QoS 隔离能覆盖全部流量、没有漏网之鱼。这就是“CNIC-Centric(以计算网卡为中心)“这个命名的由来。
3.3 “流量隔离也不是免费的”
- 第一,QoS 保护是统计意义上的,不是硬保证。 WRR 给高优 99% 带宽,前提是低优流量“守规矩”。极端突发下,KV-Cache 大流量仍可能在微观时间尺度上挤占模型通信,造成尾延迟抖动。论文用的是“保留 99% 带宽”而非“物理隔离”,本质上是在赌模型通信的平均占用远低于峰值。
- 第二,CNIC 中转有绕路成本。 论文 Practical Notes 明说:CNIC-centric 方案虽然带来了 QoS 能力,但相比直接 GPUDirect Storage 或 CUDA copy,多了一小段绕路(detour)。对 PCIe 带宽本就紧张的小模型,这份 overhead 可能不可忽略。
- 第三,强依赖网络栈能力。 VL、WRR、GPUDirect RDMA 这套组合拳,要求底层网络(IB 或支持 DCB 的 RoCE)、网卡、驱动全链路支持并正确配置。在异构、多厂商、云租户混跑的环境里,这套 QoS 未必能端到端落地——这是它对基础设施同质化程度的隐性要求。
四、自适应请求调度:把理论带宽兑现成实际吞吐
有了双路径(两个入口)和流量隔离(安全借道),还差最后一步:谁来决定每个请求走哪条路、在哪个引擎、怎么组批? 这就是调度器的活。它是把前两根支柱的“理论带宽”真正兑现成“实际吞吐”的临门一脚。论文把调度分成引擎间(inter-engine)和引擎内(intra-engine)两层。
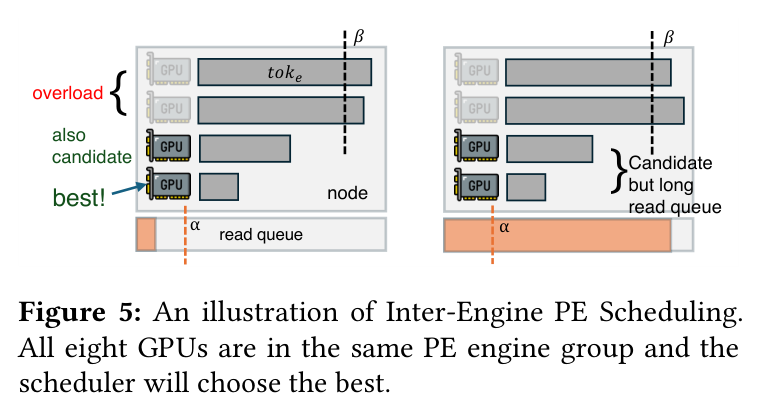
这张图画了什么:8 个 GPU 组成一个 PE 引擎组,调度器为新到的请求在组内挑选“最合适”的引擎。关键路径是调度器根据每个引擎的已排队 token 数(tok_e)和存储读队列长度(read_q),把请求路由到负载最轻的那个。它支撑的论点是:双路径提供了“选择的自由”,而这个自由只有靠一个负载感知的调度器才能用好——否则两条路一样会堵。
4.1 引擎间调度:三类引擎,优先喂“半饱”的那个
论文把 PE 引擎按两个阈值 α、β 分成三类,调度逻辑(FIFO 基础上)大致是:
- 过载引擎(token 数超上限):跳过,不再塞;
- 短队列引擎(读队列 read_q 短):最优先派发——因为它的存储网卡还有余力,正好吃新流量;
- 长队列引擎(读队列长但未过载):次优先。
对 DE 引擎则做两级平衡:跨组按总 token 数最小选组,组内按 HBM 占用与 token 数平衡。而 KV-Cache 走 PE Read Path 还是 DE Read Path,取决于哪一侧的读队列更短——这正是双路径“动态分配负载”落到实处的那行关键逻辑。
设计哲学很清晰:不是无脑均摊,而是“哪张网卡还没喝饱就喂哪张”,让全集群的存储网卡尽可能同时处于高利用但不饱和的状态。
4.2 引擎内调度:用 compute quota 削平 GPU 气泡
只有 PE 需要批内调度。做法是引入 compute quota(计算配额):预估注意力层的执行时间,FIFO 打包请求,一旦预估超界,就用二元搜索找一个批大小 z′ 做分块 prefill。目的是把 GPU 时间线上的“气泡”(bubble)削平。论文 Fig.6 展示了施加 compute quota 前后的 GPU 时序对比——之前有明显空隙,之后被填实。这是个经典的 chunked-prefill 变体,不算新,但和双路径配合能进一步榨干 PE 利用率。
4.3 调度效果:负载均衡指标从 1.53 压到 1.18
调度器好不好,看两个均衡指标就够了。论文 Fig.13、Fig.14 给出了实测。
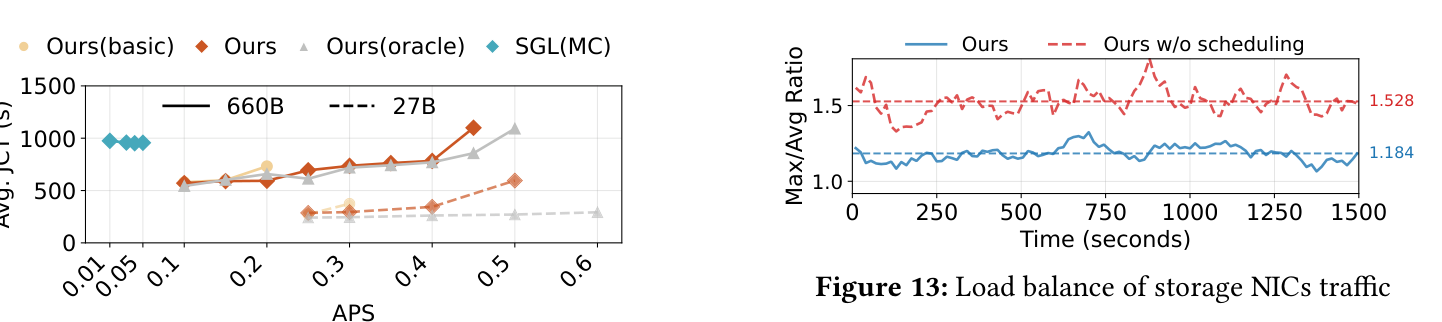
这张图画了什么:各存储网卡流量的负载均衡度(Max/Avg,越接近 1 越均衡)。关键数据点:存储网卡负载均衡度从基线的 1.53 降到 1.18——即最忙网卡与平均负载的比值大幅收敛。配套的 Fig.14 显示注意力执行时间的 Max/Avg 低至 1.06,几乎完美均衡。它支撑的论点是:双路径不是纸上带宽,调度器确实把流量摊平了,让“全局带宽池”名副其实。
五、实测收益:扎实、诚实、不吹
DualPath 基于 DeepSeek 内部推理框架实现,改动量约 5000 行代码(用了 FlashMLA、DeepGEMM、DeepEP,存储后端为 3FS,接口类似 io_uring)。这个“5K 行”数字本身就说明它是“在成熟框架上做的外科手术”,而非推倒重来。评估在每节点 8 Hopper GPU + 8×400 Gbps IB 计算网卡 + 1×400 Gbps 存储网卡的集群上进行,对比基线包括 SGL(MC)、Basic、Oracle。
5.1 离线批量推理:最高 1.87×
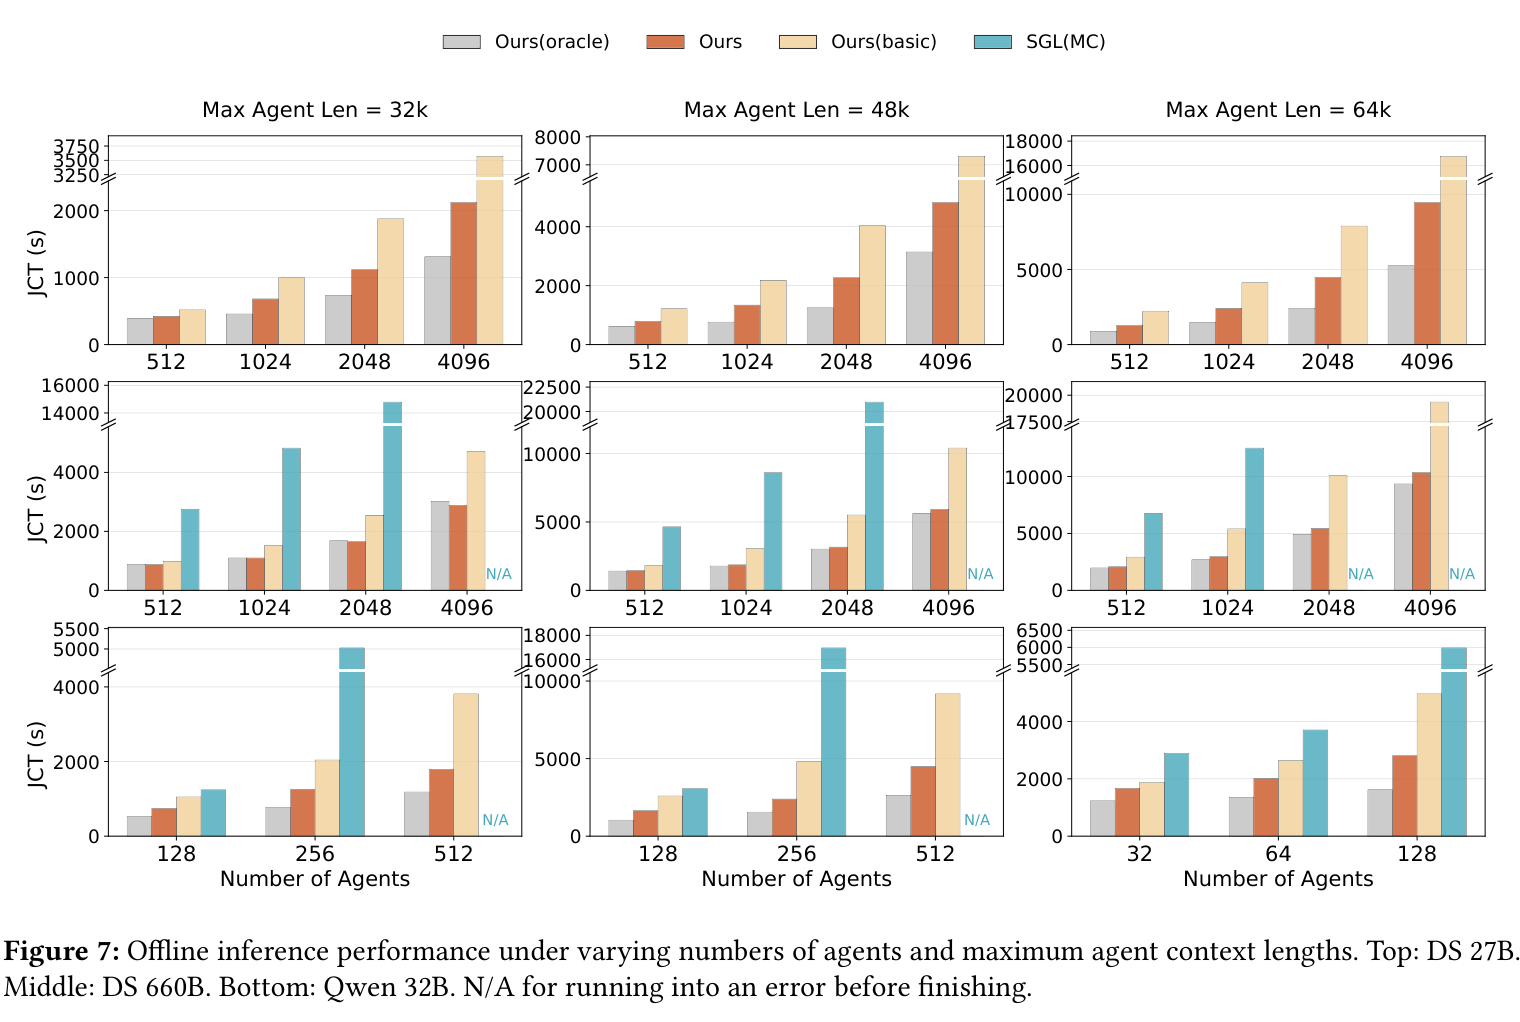
这张图画了什么:三个模型(上 DS 27B、中 DS 660B、下 Qwen 32B)在不同 agent 数量、不同最大上下文长度下的作业完成时间(JCT,越低越好)。关键数据点:DS 660B 上 DualPath 相比 Basic 最高提速 1.87×,DS 27B 最高 1.78×,Qwen 32B 类似。图中标 N/A 的是基线在跑完前就 OOM/报错的点——这本身也是一种对比:DualPath 能跑通基线跑不动的规模。它支撑的论点是:收益在多模型、多规模下稳定复现,不是单点调参凑出来的。
论文还测了 P/D 配比的影响(Fig.8):
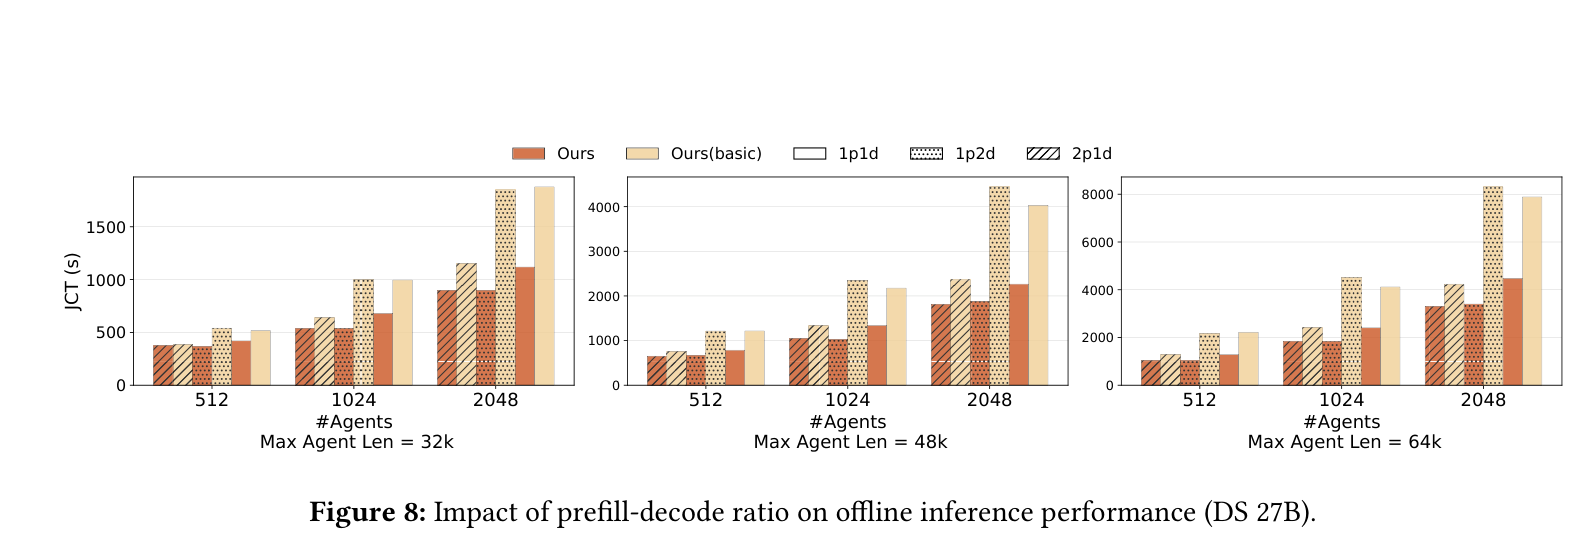
这张图画了什么:DS 27B 在不同 P/D 配比下的 JCT。关键数据点:DualPath 平均加速 1.64×,最高 2.46×。它支撑的论点是——也是论文 Practical Notes 里最重要的一句——DualPath 的真正优势是“能吃任意 P/D 配比而不浪费任何一侧的存储带宽”。一个 Basic 的 1P2D 系统和一个 DualPath 的 2P1D 系统,总存储带宽相同、性能也相当;但 DualPath 不需要为了配平存储带宽而被迫锁定某个 P/D 比,它能在任何配比下都把两侧网卡用满。这是“带宽池化”最实用的红利。
5.2 在线服务:平均 1.96×,且守住 SLO
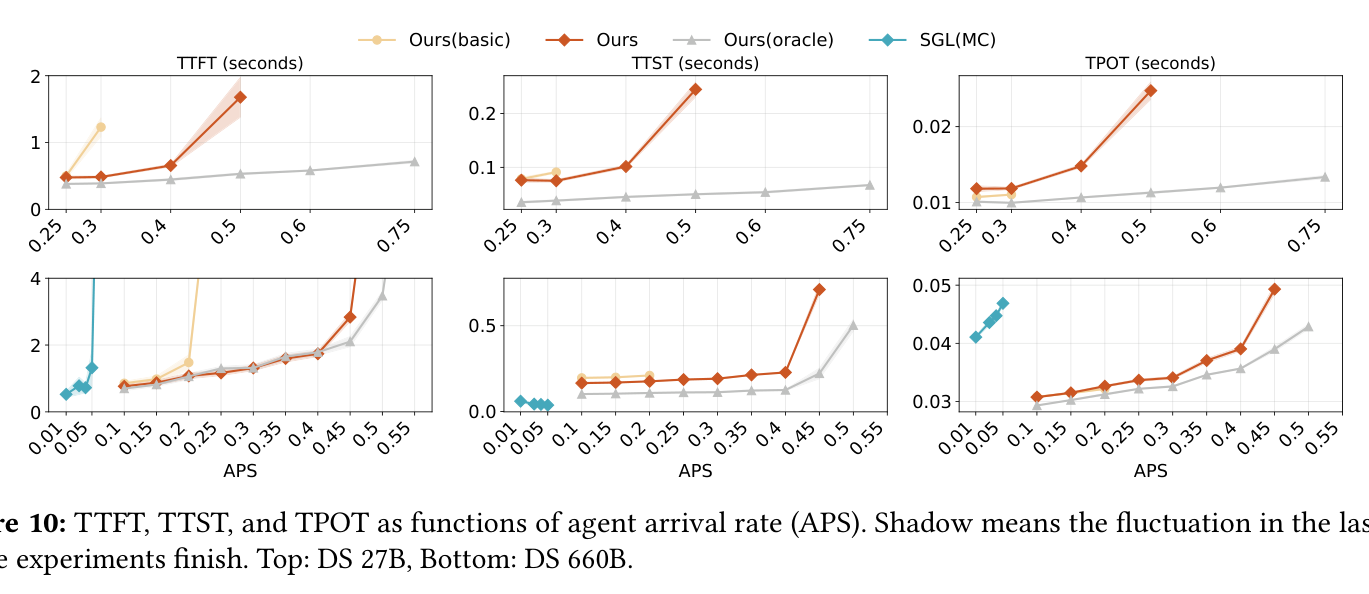
这张图画了什么:首 token 延迟(TTFT)、首 step 延迟(TTST)、每 token 延迟(TPOT)随 agent 到达率(APS)的变化。关键数据点:在 SLO(TTFT ≤ 4 s、TPOT ≤ 50 ms)约束下,DualPath 的 APS 承载能力相比 Basic:DS 27B 1.67×,DS 660B 2.25×;随负载上升,基线的 TTFT 因存储网卡饱和而飙升,DualPath 的 TTFT 则保持平稳。TTST 与基线相当,说明没有引入额外的解码开销。它支撑的论点是:反向路径的收益是“净收益”——扩了 prefill 侧吞吐,却没牺牲解码延迟。
5.3 消融实验:把功劳诚实地拆开
这是我判断一篇系统论文可信度的关键一环。DualPath 没有把 45% 的收益笼统归给“我们的系统”,而是 Fig.12 逐项拆解。
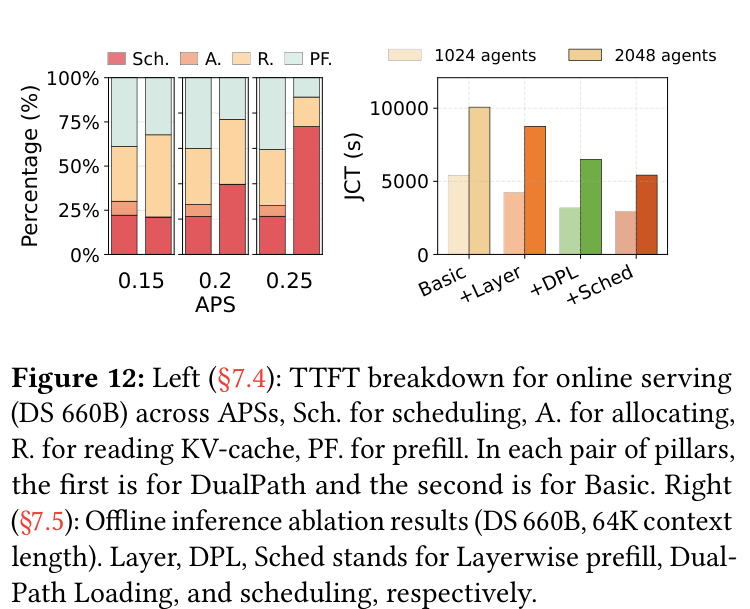
这张图画了什么:左图是在线 TTFT 的分解(调度 Sch. / 分配 A. / 读 KV-Cache R. / prefill PF.,每对柱子左为 DualPath 右为 Basic);右图是离线消融(Layer=层化 prefill,DPL=双路径加载,Sched=调度)。关键数据点(DS 660B、64K 上下文、2048 agents):
- 仅层化 prefill:降 JCT 17.21%(靠隐藏 HBM 传输开销);
- 加双路径加载:累计 38.19%(即 DPL 单独再贡献约 21%,靠把可用存储带宽翻倍);
- 再加调度器:累计 45.62%(调度再贡献约 8%,靠均衡负载)。
它支撑的论点是:三根支柱各司其职、逐级叠加,双路径本身是最大贡献项(约 21 个百分点),调度器是把它兑现的放大器。这种“不抢功、把每一分收益归给对应机制”的写法,比笼统报个 1.87× 可信得多。
5.4 大规模可扩展性:1152 GPU,近线性
论文在最大 1152 GPU 上做了扩展性测试:离线从 2P4D(2K agents,JCT 3167s) 扩到 48P96D(48K agents,JCT 3201s),JCT 几乎不变(近线性扩展);在线 44P88D 配置达到 8.8 APS(vs 基线 0.4 APS),吞吐 22×,而调度器 CPU 占用始终 <10 核。调度开销可忽略、扩展性近线性——对生产落地是两个关键的定心丸。
六、组织归因:为什么是 DeepSeek + 北大 + 清华做出了 DualPath
康威定律说:系统架构反映组织的沟通结构。这一节我不谈技术细节,专谈一件事——为什么 DualPath 长成这个样子,而不是别的样子? 我的核心判断是:DualPath 是“全栈自控”这一组织现实的必然产物。 换一个组织约束,这套方案大概率不会、也不该被这样设计。
6.1 生态位图谱:DeepSeek 控制什么,依赖谁
先把这个作者组合的资源版图摆出来:
- 模型自己造:DeepSeek-V3 / V3.2 用的是自研 MLA(Multi-head Latent Attention),KV-Cache 被架构性压到极小(Table 1 里 DS-V3 缓存-计算比全表最低)。
- 推理引擎自己写:DualPath 是在 DeepSeek “内部推理框架”上改 5000 行做出来的,配套 FlashMLA / DeepGEMM / DeepEP 全是自研并开源的算子库。
- 存储自己搞:后端是 3FS(Fire-Flyer File System),DeepSeek 2025 年开源的分布式文件系统,其存储网卡“无内部 DRAM 缓存、能打满 400 Gbps”这一特性被论文直接当作设计前提。
- 网络自己调:论文能贴出 IB 的
qos_vlarb精确参数,说明他们对计算网的 VL/WRR 配置有完全的话语权。 - 算法团队现成:北大金鑫组是 PD 分离(DistServe,OSDI 2024)的原创团队,清华张明星在分布式系统上有积累。
收束成两条对偶判断:凡是 DualPath 敢做的激进假设(存储网卡特性、计算网 QoS、模型 KV 小、层化 prefill 可控),背后都是“这一层我自己说了算”;凡是别的方案不敢做的,往往是因为那一层攥在别人手里。
6.2 设计哲学:把外部依赖变成内部可调度的池
给 DualPath 的哲学起个名字,我会叫它 “把结构性闲置的资源,变成自己能调度的池”。它反复用同一招:
| 决策点 | 传统方案 | DualPath 方案 | 复杂度 / 资源归属变化 |
|---|---|---|---|
| KV-Cache 加载入口 | 只走 PE 存储网卡 | PE + DE 双入口 | 把 DE 闲置网卡纳入自己的带宽池 |
| KV-Cache 传输网络 | 单独存储网 / 直连 | 借道计算网 RDMA + VL QoS | 把计算网闲带宽纳入自己的调度 |
| 本地 H2D 拷贝 | cudaMemcpyAsync | CNIC RDMA Write | 把本地拷贝也收敛到统一可控的 CNIC |
| P/D 配比 | 需配平存储带宽 | 任意配比无浪费 | 把“配比自由度”从约束变成红利 |
每一行的共同点:发现一处“结构性闲置或被外部约束的资源”,然后用一套机制把它变成自己能动态分配的池。 而能这么做的前提,是这些资源恰好都在 DeepSeek 的控制范围内。
6.3 横向对比:换个组织,选择就不同
同样面对 KV-Cache 加载瓶颈,不同组织结构的玩家给出了完全不同的答案,没有绝对优劣:
- Moonshot AI(Mooncake):Kimi 的服务平台,选择用分布式 DRAM 池缓存 KV-Cache。为什么是 DRAM 而不是“偷 DE 网卡”?【推测】因为 Moonshot 的组织重心在“极致降 TTFT、扛住 Kimi 的超载流量”,它更愿意用 DRAM 成本换命中率;而 DualPath 明确指出 DRAM 方案在 RL rollout(DRAM 被占)和超大工作集(DRAM 比 SSD 贵)场景下不划算——这恰恰是 DeepSeek 既做训练又做推理、场景更宽的组织现实决定的。
- 公有云厂商(AWS / 阿里云 / 腾讯等):服务的是第三方模型 + 多租户。它们很难假设“模型 KV 一定小”(客户什么模型都有),也很难把存储流量和客户的模型通信塞进同一张网做 QoS(租户隔离、SLA 边界横在中间)。【个人认为】对云厂商,DualPath 这种“全栈 co-design”的路子结构性地走不通,它们更可能走“标准化的分布式 KV 缓存服务 + 客户自选”的路线。
- DeepSeek(DualPath):单租户、自研模型、自控存储与网络——唯一有资格把上述所有层揉在一起做端到端 co-design 的组织。
结论固定:这些路线没有绝对优劣,各自在自己的组织约束下都是合理的——背后不是技术先进性的差距,而是“你能控制哪些层”的差距。
6.4 DualPath 丢掉了什么(取舍代价集中梳理)
- 第一,通用性。 它假设了 agentic 负载(长上下文、短追加、≥95% 命中)。不适用:单轮长文档生成、低命中率的多样化 prompt、RAG 冷查询。
- 第二,DRAM 余量。 DE buffer 吃 DRAM,与 RL rollout 的训练状态直接冲突——论文自己都承认这是它相对 Mooncake 反而占优的场景,但也是它自身 DRAM 压力的来源。
- 第三,PCIe 预算。 CNIC 中转的绕路 overhead,对 PCIe 紧张的小模型可能得不偿失。
- 第四,基础设施同质化。 VL QoS、GPUDirect RDMA、3FS 特性,缺一环就打折扣。异构 / 多厂商 / 云租户环境里难以端到端落地。
6.5 一段值得品味的原文
“DualPath could be combined with a distributed DRAM cache (like Mooncake), but the paper notes the marginal performance gain is small.”
这话说得很客气——“边际收益很小”——但潜台词其实是:在 DeepSeek 的组织语境里(自研 3FS + 存储网卡能打满 400 Gbps + 模型 KV 已经很小),SSD 直取已经够快,再叠一层 DRAM 缓存性价比不高。 换到一个存储后端拉胯、或模型 KV 巨大的组织,这个“边际收益很小”的结论可能完全反过来。作者不是在说“DRAM 缓存没用”,而是在说“在我们的栈里没必要”——这正是组织语境决定技术取舍的活教材。
6.6 自问自答
为什么敢新增 storage→decode 反向路径? 因为存储、网络、引擎全在自己手里,改数据流不用求任何人。
为什么敢把存储流量塞进计算网? 因为计算网的 VL/WRR 配置自己说了算,能精确保留 99% 给模型通信。
为什么不像 Mooncake 那样堆 DRAM 缓存? 因为自研 MLA 让 KV 已经很小、自研 3FS 能打满带宽,且要兼顾 DRAM 被占满的 RL 场景。
为什么是同一批人(DistServe 团队)来补这个洞? 因为 PD 分离是他们两年前亲手拆出来的,“带宽不均衡”这个后遗症,他们最清楚也最有动机去修。
每一个“为什么”,都不是单纯的技术选择。它们是 DeepSeek 在自己的全栈自控、单租户业务、训推一体的组织约束下,找到的局部最优解。 这提醒我们——任何技术方案的合理性,都和它所在的组织语境强绑定。 看到 DualPath 的 1.96× 时,下一个问题永远应该是:“我所在的组织,能控制的层,和 DeepSeek 一样多吗?”
七、适用边界与行业借鉴
7.1 舒适区:四个条件同时满足才值得直接借鉴
条件一:负载是 agentic 形态——长上下文、短追加、高命中率(≥95%)。 这是 DualPath 全部收益的前提。命中率一旦掉下来,KV-Cache 大量需要现算,瓶颈就从 I/O 退回算力,双路径无用武之地。
条件二:确实撞到了存储带宽墙,而非算力墙。 如果你的 GPU 本就吃不饱、prefill 算力才是瓶颈,那先该做的是 chunked prefill / 更好的并行,而不是双路径。
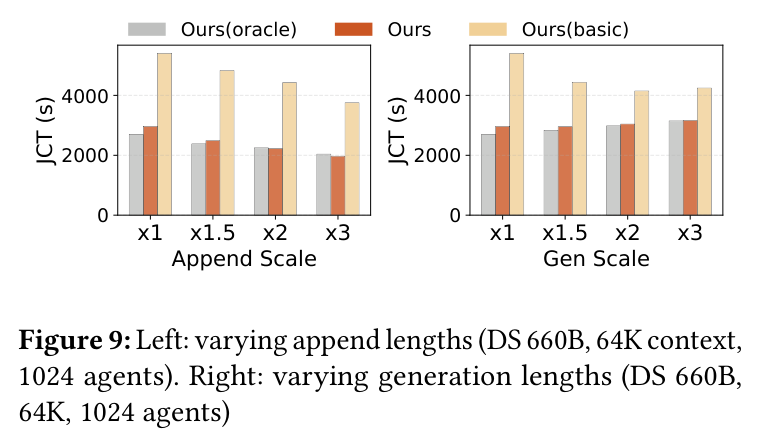
这张图恰好量化了这条边界:左图是 append 长度变化时 DualPath 相对 Basic 的加速。关键数据点:append 短时加速 1.82–1.99×;但论文 Practical Notes 明说,append 长度扩到 3× 时,Basic 的性能已逼近 Oracle——因为 append 变长后,GPU 算力重新成为瓶颈,存储 I/O 不再是短板,DualPath 的优势随之收窄。这就是舒适区的右边界。
条件三:P/D 配比落在无瓶颈区间内(典型 1/7 ≤ P/D ≤ 7/2)。 超出这个区间,双路径会出现新的瓶颈(PCIe / CNIC / DRAM 之一先饱和)。
条件四:基础设施你能控制——存储后端、计算网 QoS、推理引擎都可改。 少一样,收益就打折。
收束:四条全满足,可直接借鉴;有一条不满足,就要谨慎评估。
7.2 三类不适配场景
场景一:公有云多租户推理服务。 原因是结构性的。第一,云上客户模型五花八门,无法假设 KV-Cache 小、命中率高;第二,把存储流量塞进计算网做 VL QoS,会击穿租户隔离与 SLA 边界;第三,P/D 配比往往由客户或计费模型决定,调度器难以自由重路由。正确路线:走标准化的分布式 KV 缓存服务(如 Mooncake Store / LMCache 这类可插拔组件),把带宽优化留给客户自选。
场景二:DRAM 受限的 RL 训练 rollout。 DE buffer 要吃 DRAM,而 rollout 阶段 DRAM 被从 HBM offload 下来的训练状态占满,两者直接冲突。第一,此时该优先保训练状态;第二,可考虑用 SSD 直取 + 更激进的 prefetch 替代 DE buffer 中转。(有趣的是,论文恰恰把“DRAM 被占”当作 DualPath 优于 Mooncake 的场景——但那是指“不该用 DRAM 缓存”,不等于“DE buffer 就没压力”,要分清。)
场景三:小模型 / PCIe 紧张的部署。 CNIC 中转的绕路 overhead 在小模型上占比升高,可能吃掉双路径的收益。第一,小模型 KV 本就小,存储 I/O 未必是瓶颈;第二,直接 GPUDirect Storage 或 CUDA copy 反而更省。正确路线:先 profiling 确认瓶颈真在存储带宽,再决定是否上双路径。
7.3 分群体建议(面向国内同行)
给超大型云厂商(阿里云 / 腾讯云 / 火山等):
- 第一,别照抄 CNIC-centric co-design——你的多租户约束决定了它落不了地;应把精力放在标准化、可插拔的分布式 KV 缓存服务上,让客户自选带宽策略。
- 第二,可以借鉴的是**“存储网卡负载均衡度”这个运维指标**(Max/Avg,DualPath 做到 1.18)——把它纳入你的推理集群 SLA 监控,量化“带宽是否被浪费”。
- 第三,向 IB/RoCE 生态推动租户级 VL/DSCP QoS 的标准化,为未来单租户大客户的 co-design 留接口。
给 AI 头部公司(自研模型 + 自建集群,如字节 / 阶跃 / 智谱 / MiniMax 等):
- 第一,这是最该深度学习 DualPath 的群体——你们同样全栈自控。优先评估自家 agentic 负载的命中率和 P/D 配比是否落在舒适区,落在就值得投入。
- 第二,把双路径 + VL QoS 作为推理引擎的一等公民能力来建设,而不是事后打补丁;重点复现“本地拷贝改走 RDMA”这个低垂果实(5–7 μs → 1 μs)。
- 第三,若模型是 MHA/GQA(KV 大),收益会比 DeepSeek 的 MLA 更明显——因为你的存储 I/O 压力本就更大(回看 Table 1,Qwen2.5-32B 缓存-计算比是 DS-V3 的近 50 倍)。
给传统行业自建集群(金融 / 制造 / 运营商私有云):
- 第一,大概率用不上也不该上 DualPath——你的规模、负载多样性、基础设施可控度都不匹配。先把 PD 分离和前缀缓存这些“地基”打好。
- 第二,真正该学的是分析模型的思维:在动手前,用一个类似 1/7 ≤ P/D ≤ 7/2 的判据,先算清楚“我的瓶颈到底在算力还是 I/O、在哪个配比下平衡”,避免拍脑袋堆硬件。
- 第三,关注 vLLM / SGLang 对 Mooncake Store 等组件的集成进展,等生态成熟后直接用现成轮子,而非自研。
八、结语
DualPath 不是终点,是一个里程碑。它真正的价值不在于协议或算法有多创新——事实上它几乎每块地基都来自既有工作——而在于它向行业干净利落地证明了一件事:在 agentic 推理这个 I/O 主导的新战场上,“把被结构性闲置的资源变成可调度的全局池”是一条通往数量级收益的可行路径。
国内同行学 DualPath,不是要照搬它的 storage→decode 数据流、不是要照抄它的 qos_vlarb 参数、不是要复刻它的 CNIC 中转——而是要学它**“先看清哪半张网卡在睡觉,再想办法把它叫醒”这种把浪费当作机会的工程直觉,以及“能这么做,是因为这些层都在我手里”**这份对组织约束的清醒。
闲置即浪费,浪费即瓶颈;而破局点,往往就是那个所有人都视而不见的、空闲的另一半。
这个哲学,比任何一条具体的数据路径都重要。
九、参考材料
- 《DualPath: Breaking the Storage Bandwidth Bottleneck in Agentic LLM Inference》,Yongtong Wu 等,北京大学 / 清华大学 / DeepSeek-AI,arXiv:2602.21548,2026-02。
- 《DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving》,Yinmin Zhong 等,OSDI 2024,arXiv:2401.09670。
- 《Splitwise: Efficient Generative LLM Inference Using Phase Splitting》,Pratyush Patel 等,ISCA 2024,arXiv:2311.18677。
- 《Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving》,Ruoyu Qin 等,FAST 2025(最佳论文),arXiv:2407.00079。
- 《LayerKV: Optimizing Large Language Model Serving with Layer-wise KV Cache Management》,Xiong 等,2024。
- 《SGLang: Efficient Execution of Structured Language Model Programs》(RadixAttention),MLSys 2025。
- DeepSeek 3FS(Fire-Flyer File System)开源仓库与技术说明,2025。
- NVIDIA GPUDirect RDMA 官方文档;InfiniBand Architecture Specification(IBTA,Virtual Lane / WRR QoS)。
- 机器之心:《DeepSeek 新论文来了!联手清华、北大,优化智能体大模型推理》,2026-02。
十、术语表
拓扑与架构类
- PD 分离(Prefill–Decode Disaggregation):把 LLM 推理的 prefill(处理 prompt、生成首 token 与 KV-Cache)与 decode(逐 token 生成)两个阶段分配到不同 GPU 引擎上,消除彼此干扰、各自独立优化并行与配比。源自 DistServe(2024)。本文的整个瓶颈都产生于这个架构。
- PE(Prefill Engine,预填充引擎):专门做 prefill 的 GPU 引擎。传统架构里它的存储网卡是全系统瓶颈。
- DE(Decode Engine,解码引擎):专门做 decode 的 GPU 引擎。其存储网卡在传统架构里大量闲置,是 DualPath 要“偷”的对象。
- P/D 配比(P/D ratio):PE 节点数与 DE 节点数之比。DualPath 证明在 1/7 ≤ P/D ≤ 7/2 区间内可做到无瓶颈。
- 3FS(Fire-Flyer File System):DeepSeek 自研并开源的分布式文件系统,本文实验的 KV-Cache 存储后端,其存储网卡无内部 DRAM 缓存、可打满 400 Gbps。
机制类
- KV-Cache:Transformer 注意力层缓存的 Key/Value 张量,避免重复计算历史 token。在 agentic 长上下文场景下体积巨大,其加载是 I/O 瓶颈的根源。
- 双路径加载(Dual-Path Loading):DualPath 的核心机制。除传统 storage→prefill 路径外,新增 storage→decode 路径,KV-Cache 先落 DE 再经计算网 RDMA 回传 PE,等效于合并两侧存储带宽。
- PE Read Path / DE Read Path:双路径的两条腿。前者 KV-Cache 经 PE 存储网卡进入,后者经 DE 存储网卡进入再回传。
- 层化 prefill(Layer-wise Prefill):逐层分配/释放 KV-Cache,HBM 里只驻留单层,从而把有效 batch size 提升到“层数倍”,提高 GPU 利用率。DualPath 的前置技术,消融中单独贡献 17.21%。
- Full Block / Layer Block:KV-Cache 的两种数据布局。Full Block(含所有层)用于与存储交互(利于大块顺序读);Layer Block(单层)用于 PE HBM 与 DE buffer 间的层级流式传输(利于与逐层计算重叠)。
- CNIC-Centric 流量管理:让所有 GPU 相关流量(含本地拷贝)统一走计算网卡(CNIC)的 GPUDirect RDMA,以便用统一的 QoS 隔离全部流量。
- Virtual Lane(VL,虚拟通道):InfiniBand 在同一条物理链路上划分的多条逻辑通道,可赋予不同优先级。DualPath 用高优 VL 跑模型通信、低优 VL 跑 KV-Cache。
- WRR(Weighted Round Robin,加权轮询):在多条 VL 间按权重分配带宽的仲裁策略。DualPath 配置为给高优先级保留约 99% 带宽。
- compute quota(计算配额):引擎内调度用的机制,通过预估注意力层执行时间来打包/分块请求,削平 GPU 时间线上的气泡。
- 自适应请求调度(Adaptive Request Scheduler):实时监控各引擎读队列长度与计算负载,为每个请求动态选路(PE/DE Read Path)与组批的全局调度器。
指标与周边类
- 命中率(KV-Cache hit rate):可复用的 KV-Cache 占比。agentic 负载下高达 ≥95%(论文 trace 98.7%),是 I/O 主导性能的前提。
- 缓存-计算比(cache-compute ratio, GB/PFLOP):每 PFLOP 计算需搬运多少 GB KV-Cache,衡量负载 I/O 密集程度。DS-V3.2 约 22,Qwen2.5-32B 高达 267。
- I/O-计算比(I/O-compute ratio):GPU 可用 I/O 带宽与算力之比。从 Ampere 到 Blackwell 下降了 14.4×,是 I/O 瓶颈长期恶化的硬件根因。
- JCT(Job Completion Time):离线批量推理的作业完成时间,越低越好。DualPath 最高降 45.62%。
- TTFT / TTST / TPOT:首 token 延迟 / 首 step 延迟 / 每 token 延迟,在线服务的三大延迟 SLO 指标。本文 SLO 设 TTFT ≤ 4 s、TPOT ≤ 50 ms。
- APS(Agent runs Per Second,每秒 agent 运行数):在线服务的吞吐指标。大规模下 DualPath 达 8.8 APS,为基线 0.4 的 22×。
- 负载均衡度(Max/Avg):最忙资源与平均负载之比,越接近 1 越均衡。DualPath 把存储网卡从 1.53 压到 1.18、注意力执行时间做到 1.06。
- MLA(Multi-head Latent Attention):DeepSeek 自研的注意力变体,通过潜在压缩把 KV-Cache 体积大幅缩小,使 DS 系列缓存-计算比全表最低。
- Mooncake:Moonshot AI(Kimi)的 KVCache-centric 分布式 DRAM 缓存架构,FAST 2025 最佳论文。DualPath 的主要对照对象,二者代表不同组织约束下的不同取舍。
- GPUDirect RDMA:NVIDIA 技术,允许网卡直接读写 GPU HBM,绕过 CPU/主机内存,是 CNIC-centric 方案的底层能力。
- doorbell batching:RDMA 中把多个发送请求的“门铃”(发起通知)批量触发,摊薄单次发起开销,使 RDMA Write 的有效延迟低至约 1 μs。