DeepSeek-V3 硬件架构反思深度解读:在受管制硬件上榨取一流效率
从 H800、NVLink、MoE 到多平面 Fat-Tree,理解模型、通信库和网络拓扑的协同设计。
论文:Chenggang Zhao et al., Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures, ISCA ’25 Industry Track. arXiv:2505.09343.
TL;DR
1. 这不是一篇面向未来的硬件架构论文,而是一份“如何用受限硬件训练顶级模型”的工程纪实。
作者团队来自 DeepSeek-AI,核心论点贯穿全文:在无法定制芯片、无法采购最强芯片、无法自主控制网络设备的现实约束下,模型架构、通信库与网络拓扑必须被统一裁剪到硬件边界上。论文列出的四大技术支柱——Multi-head Latent Attention(MLA)、DeepSeekMoE、FP8 混合精度训练与Multi-Plane Fat-Tree(MPFT)——本质上都是对 NVIDIA H800 这型“出口管制版 Hopper”缺陷的补偿性设计。
2. MLA 把 KV Cache 压到传统 GQA 方案的 1/7,是推理内存瓶颈的“外科手术刀”。
DeepSeek-V3 每 token 的 KV Cache 仅 70.272 KB,相比之下 LLaMA-3.1 405B(GQA)需要 516.096 KB,Qwen-2.5 72B 需要 327.680 KB。这种压缩不是用性能换内存,而是通过低秩潜在向量投影在保持多头注意力表达能力的同时,把推理时的内存带宽压力从 GEMV 维度降下来。
3. DeepSeekMoE 用 671B 总参数、37B 激活参数,把训练 FLOPs 压到同能力稠密模型的 1/10。
DeepSeek-V3 的训练成本约为 250 GFLOPS/Token(序列长度 4096),而 LLaMA-3.1 405B 稠密模型需要 2448 GFLOPS/Token。MoE 的稀疏激活让总参数量与计算量解耦,配合共享专家(Shared Expert)与精细路由策略,在单 token 计算强度与模型容量之间取得了极端的性价比。
4. H800 的 NVLink 被阉割到 400 GB/s,逼出了 Node-Limited Routing 与 DeepEP 这对“带宽缺口补丁”。
H800 SXM 的 NVLink 带宽从 H100 的 900 GB/s 降到 400 GB/s,节点内有效 NVLink 带宽约 160 GB/s,而每张 400Gbps IB NIC 的有效带宽仅约 40 GB/s。4:1 的内外带宽差迫使 DeepSeek-V3 在路由层限制每个 token 最多访问 4 个节点,用 NVLink 转发做 IB 流量去重;同时用开源的 DeepEP 库把 EP all-to-all 的 dispatch/combine 吞吐推到 40 GB/s 以上,逼近 NIC 物理上限。
5. 这套方案有强烈的舒适区,盲目照搬会是灾难。
它的前提包括:拥有强算法团队做模型-通信协同设计、使用稀疏 MoE 而非稠密模型、接受 IB 网络与多平面拓扑的运维复杂度、愿意在 FP8 精度边界上做大量消融验证。对于没有强工程闭环能力、采购的是满血 H100/GB200、或者运行稠密大模型的团队,很多取舍并不成立——学“针对自身约束做最合身设计”的哲学,比抄 DeepSeek 的具体参数更重要。
引言:不应被简单理解为“硬件展望”,更应被视为“受限创新宣言”
DeepSeek-V3 在 2024 年底发布后迅速成为行业焦点,不仅因为模型能力强,更因为它声称只用了 2,048 块 NVIDIA H800 GPU 就达到了与动辄上万卡集群相媲美的效果。ISCA ’25 的这篇 Industry Track 论文,标题是 Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures,很容易让读者误以为它要描绘下一代 AI 硬件的蓝图。
但通读全文后,我的判断是:它不是在回答“下一代 AI 硬件应该长什么样”,而是在回答“当我们只有 H800 时,模型和软件必须长什么样”。 论文中每一节“未来硬件建议”的反面,都是当前硬件给 DeepSeek 造成的真实痛点;每一项被重点介绍的模型创新,都对应着硬件层面无法被改变的约束。
五个关键词可以概括全文的技术主线:
- MLA(Multi-head Latent Attention):用低秩压缩把 KV Cache 从多头注意力的内存黑洞里救出来,解决推理时的内存墙问题;
- DeepSeekMoE:用稀疏激活把总参数量与每 token 计算量解耦,用共享专家捕获通用知识,用精细路由降低通信扇出;
- FP8 混合精度训练 + LogFMT:把低精度从推理压缩手段推进到训练主路径,并用对数浮点格式进一步压榨通信带宽;
- Node-Limited Routing + DualPipe + DeepEP:针对 H800 内外带宽差所做的并行策略与通信库级补偿;
- MPFT(Multi-Plane Fat-Tree):用多平面两层胖树替代三层胖树,在规模与成本之间寻找对中国 AI 团队更可行的网络方案。
本文将沿着这条主线展开技术拆解,随后讨论这些选择背后的组织归因,最后给出适用边界与国内同行的借鉴建议。
技术支柱一:MLA 与 DeepSeekMoE——用模型层压缩对冲内存墙
1.1 MLA:把 KV Cache 从“按头存储”变成“按潜在向量存储”
大模型推理的痛点在训练完成后才真正显现。当用户请求进入多轮对话或长上下文场景时,Transformer 需要缓存之前所有 token 的 Key 和 Value,以避免重复计算。随着序列变长,KV Cache 的容量需求线性增长,而 HBM 容量增速远低于模型规模增速——这就是论文反复提到的“AI 内存墙”。
传统 Multi-Head Attention(MHA)需要为每个头单独存储 KV,GQA/MQA 通过共享 KV 减少存储,但会以注意力表达能力下降为代价。MLA 的做法是:在训练阶段学习一个低秩投影矩阵,把所有头的 KV 压缩到一个共享的潜在向量(latent vector)中;推理时只缓存这个潜在向量,需要时再通过投影恢复出各头所需的 KV。
论文给出的对比非常直观:
| 模型 | KV Cache 每 token(BF16) | 相对 DeepSeek-V3 倍数 |
|---|---|---|
| DeepSeek-V3(MLA) | 70.272 KB | 1× |
| Qwen-2.5 72B(GQA) | 327.680 KB | 4.66× |
| LLaMA-3.1 405B(GQA) | 516.096 KB | 7.28× |
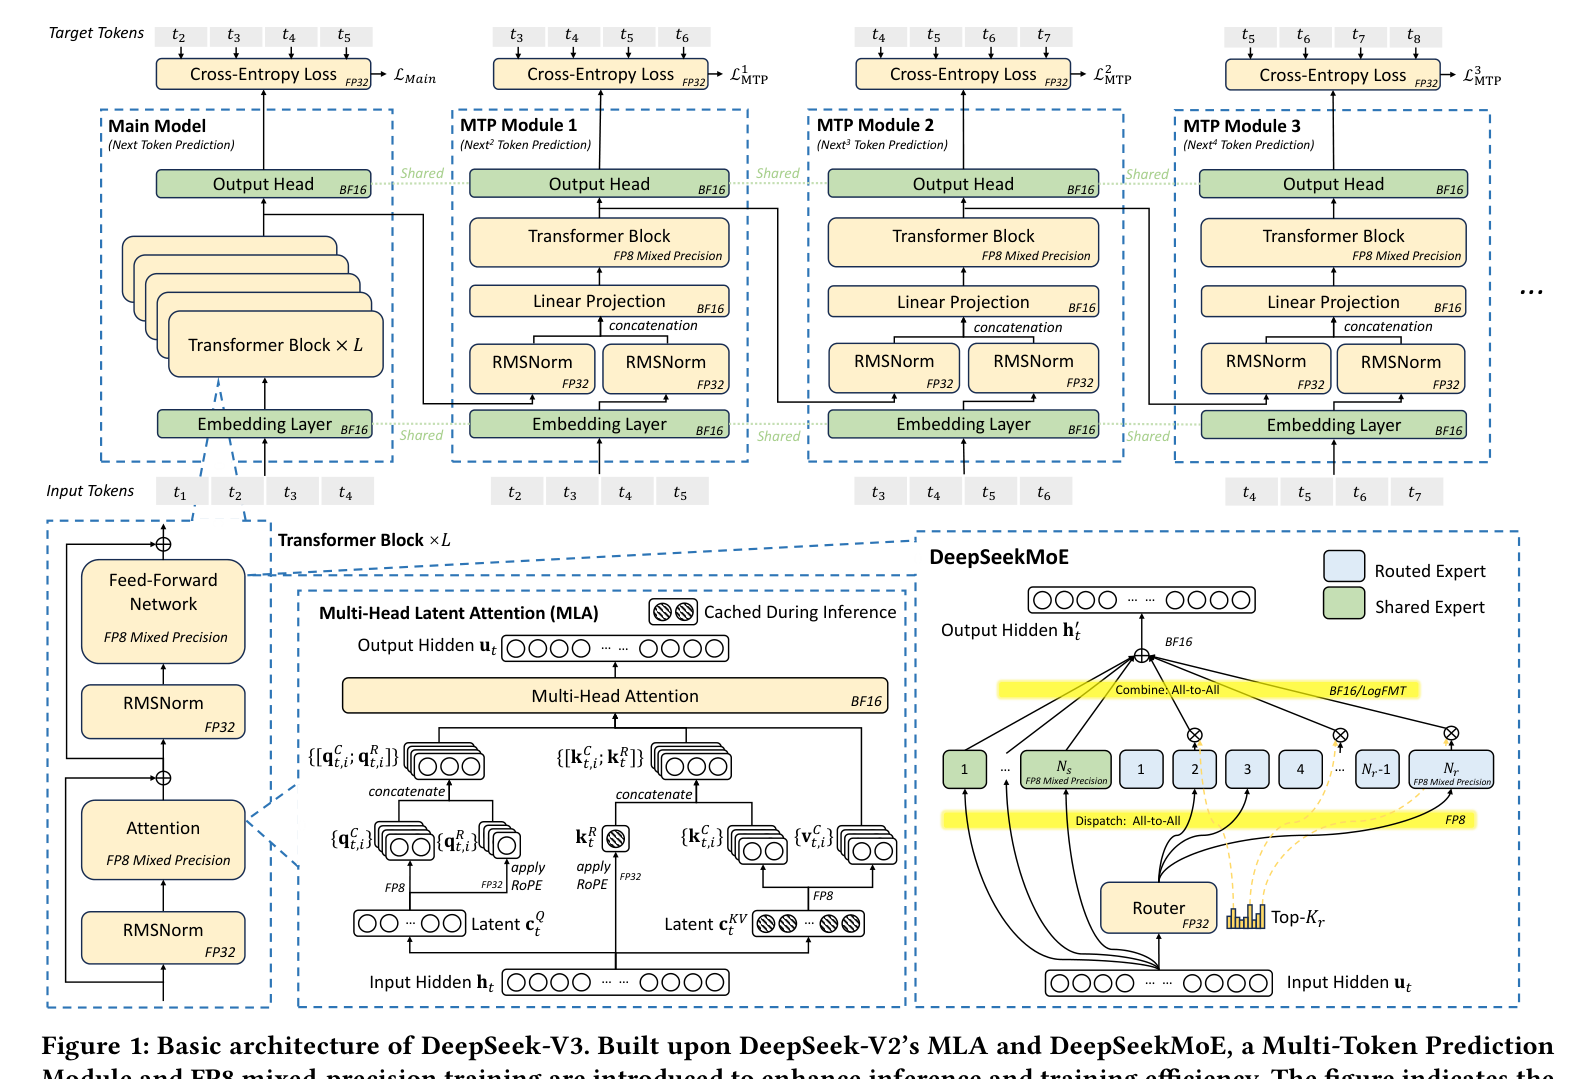
Figure 1 把 MLA 的计算路径画得很清楚:输入 hidden 经过下投影得到 latent cKVt 和 cQt,再上投影恢复多头 Q/K/V。由于下投影矩阵可以在训练后被吸收进相邻的线性层,推理时实际不需要显式做完整的“压缩-解压”计算。
从工程实现角度看,MLA 的关键在于“解耦 RoPE”(Decoupled RoPE)。标准 RoPE 把位置编码直接作用于每个头的 Q 和 K;如果 MLA 直接压缩 K,位置信息会被混在低秩投影中,导致长上下文外推能力下降。DeepSeek 的解法是:把 Q 和 K 各拆成两部分——压缩部分(cQt、cKVt)用于低秩 KV Cache,RoPE 部分(qRt,i、kRt)专门携带位置信息。计算 attention score 时,把压缩 Q 与压缩 K 的内积,加上 RoPE Q 与 RoPE K 的内积,共同作为 softmax 输入。这样,缓存里只需要存 cKVt 和 kRt,而不用存所有头的完整 K/V。
更深一层的工程细节是“矩阵吸收”。推理时,下投影矩阵 WDK、WDV 分别与上投影矩阵 WUK、WOV 可以通过线性代数合并。具体而言,WQ 可以与 WUK 合并,WO 可以与 WUV 合并,这样前向传播时直接对 latent vector 做一次矩阵乘法即可得到 attention 输出,无需显式恢复多头 K/V。这种吸收不仅减少了计算量,也减少了推理阶段的内存访问次数——对于内存带宽受限的 decode 阶段尤为关键。
Figure 1 解读:这是一张信息密度极高的总览图。上半部分是 Multi-Token Prediction(MTP)模块,主模型之外并行挂着多个预测后续 token 的轻量模块;下半部分是单个 Transformer Block 的展开,左侧是 FFN + RMSNorm,中间是 MLA,右侧是 DeepSeekMoE。注意图中标注的精度:MLA 内部大量计算用 FP8,输入输出保持 BF16,RMSNorm 用 FP32——这是整篇论文“低精度驱动设计”的可视化总纲。
1.2 DeepSeekMoE:稀疏激活把参数规模与计算量解耦
MoE 的核心思想并不新鲜——1991 年 Jacobs 等人提出“Adaptive Mixture of Local Experts”,2017 年 Shazeer 等人把稀疏门控 MoE 应用到 LSTM 语言模型。但 DeepSeekMoE 的贡献在于把“细粒度专家 + 共享专家 + 设备级路由约束”组合成一个在中国硬件约束下可落地的方案。
论文给出的数据如下:
| 模型 | 总参数量 | 每 token 激活参数量 | 训练计算成本(4096 序列长度) |
|---|---|---|---|
| DeepSeek-V2 MoE | 236B | 21B | 155 GFLOPS/Token |
| DeepSeek-V3 MoE | 671B | 37B | 250 GFLOPS/Token |
| Qwen-72B Dense | 72B | 72B | 394 GFLOPS/Token |
| LLaMA-3.1 405B Dense | 405B | 405B | 2448 GFLOPS/Token |
也就是说,DeepSeek-V3 用约 1/10 的训练 FLOPs 达到了与 405B 稠密模型可比的能力。这里的关键不是“参数多”,而是“激活参数少”——671B 总参数中每 token 只激活 37B,稀疏度超过 94%。
Figure 1 右侧的 DeepSeekMoE 子图显示了两个关键设计:
- Shared Expert:每个 token 必然经过的共享专家,捕获通用语言知识;
- Routed Expert:通过 Top-Kr 路由选择的专家,负责任务特化知识。
这种分工让模型既能保持大容量,又能把通信扇出限制在可管理的范围内。
1.3 Multi-Token Prediction:用自推测解码换推理延迟
论文 Figure 1 上半部分展示了 Multi-Token Prediction(MTP)模块。MTP 并非 DeepSeek 首创,其思想来自 Gloeckle 等人 2024 年发表在 ICML 的论文 Better & Faster Large Language Models via Multi-token Prediction。传统自回归模型每个 decoding step 只生成一个 token,顺序瓶颈明显;MTP 则在主模型之外并行训练多个轻量模块,每个模块预测更后面的 token,然后用主模型并行验证这些候选 token。
DeepSeek-V3 的 MTP 实现有几个特点:
- 每个 MTP 模块只有单层 Transformer Block,参数量远小于主模型;
- MTP 模块与主模型共享 Embedding 层和 Output Head;
- 训练时 MTP 作为辅助损失,不增加主模型前向开销;
- 推理时 MTP 提供候选 token,主模型做并行验证,实现类似 self-speculative decoding 的加速。
论文给出的实测数据是:MTP 对第二个后续 token 的接受率达到 80%–90%,整体生成 TPS 提升约 1.8 倍。 这个数字非常可观,因为它几乎不增加额外计算资源,只是把主模型已经计算出的特征复用起来。
但 MTP 的价值不止于单请求延迟。论文特别强调,MTP 通过每个 step 生成更多 token,等效增大了推理 batch size,从而提升了 EP 阶段的计算强度和 GPU 利用率。对于 MoE 模型而言,小 batch 下的专家利用率往往很低;MTP 让更多 token 同时进入专家计算,缓解了这个问题。
1.4 “不是免费的”:MLA、MoE 与 MTP 的隐性代价
天下没有免费午餐。MLA 和 MoE 的代价主要体现在以下几个方面:
第一,MLA 的 RoPE 兼容性增加了实现复杂度。 MLA 为了保留位置编码能力,采用了“解耦 RoPE”(Decoupled RoPE):把查询和键分成压缩部分(用于低秩 KV Cache)和 RoPE 部分(用于位置编码)。这要求推理框架在 KV Cache 管理中维护两套向量,对 vLLM/SGLang 等推理引擎的页式内存管理提出了额外要求。
第二,MoE 的负载均衡是训练稳定性的命门。 论文没有详细展开,但 DeepSeek-V2/V3 的技术报告都提到使用了专家级、设备级、通信级三类负载均衡损失。如果路由崩塌(router collapse),某些专家会被过度使用而另一些专家被闲置,模型容量优势就会丧失。
第三,MoE 的通信模式天然比稠密模型更复杂。 每个 token 需要被 dispatch 到多个专家,计算完后再 combine 回来。这意味着 all-to-all 通信成为训练的关键路径,对网络拓扑和通信库提出了刚性要求——这也解释了为什么论文后半部分花大量篇幅讨论 MPFT 和 DeepEP。
第四,稀疏激活对推理 batching 不友好。 如果 batch 中不同请求路由到的专家集合差异很大,就很难把同一专家的计算在 GPU 上聚合成大 GEMM,导致 GPU 利用率下降。论文在 Section 2.3 中承认,MoE 推理速度的上限很大程度上受限于 all-to-all 通信带宽。
1.4 技术溯源表
| 特性 | 最早公开出处 | 年份 |
|---|---|---|
| Mixture of Experts(专家混合) | Jacobs et al., Adaptive Mixture of Local Experts | 1991 |
| 稀疏门控 MoE 用于 NLP | Shazeer et al., Outrageously Large Neural Networks | 2017 |
| GShard / Expert Parallelism | Lepikhin et al., GShard: Scaling Giant Models with Conditional Computation | 2020 |
| Switch Transformer(Top-1 路由) | Fedus et al., Switch Transformers | 2021 |
| MQA / GQA(KV Cache 压缩) | Shazeer 2019 / Ainslie et al. 2023 | 2019 / 2023 |
| MLA(Multi-head Latent Attention) | DeepSeek-V2 Technical Report | 2024 |
| DeepSeekMoE(细粒度 + 共享专家) | DeepSeekMoE Technical Report | 2024 |
判断:DeepSeek-V3 在模型架构层面没有发明全新的基础机制,而是把 MLA、DeepSeekMoE、FP8、MTP 等既有机制在 H800 集群上做了端到端整合与大规模生产验证。它的真正增量是“在中国硬件约束下的可落地性”。
技术支柱二:FP8 与 LogFMT——低精度是把双刃剑
2.1 FP8 混合精度:把 Hopper 的硬件特性用到极限
在 DeepSeek-V3 之前,FP8 主要被用于推理量化(如 NVIDIA TensorRT、各种 PTQ 方案),很少有开源大模型敢于在训练主路径上使用 FP8。论文明确写道:
“NVIDIA’s Transformer Engine has supported FP8 mixed-precision training for some time, but prior to DeepSeek-V3, there were no open-source large models leveraging FP8 for training.”
这句话说得很客气——翻译一下就是:FP8 训练在硬件上早就可行,但社区没人敢用,因为精度风险太大。 DeepSeek-V3 敢用的底气来自两点:一是细粒度量化策略(tile-wise 1×128 对 activation,block-wise 128×128 对 weight),二是 DeepGEMM 中开源的高效 FP8 GEMM 实现。
Figure 1 中用颜色标注了 FP8 的应用位置:FFN、Attention 的线性投影、MoE 的专家计算等核心矩阵乘法大量使用 FP8,而 RMSNorm、Softmax、路由等敏感操作保持 BF16/FP32。论文称,在 16B 和 230B 模型上做消融验证后,FP8 相对于 BF16 的精度损失低于 0.25%。
2.2 FP8 的硬件局限:精度与反量化开销
论文对 FP8 的批判非常坦诚,这也是我认为全文最有价值的部分之一。作者指出了两个核心硬件限制:
第一,FP8 累加精度不足。 NVIDIA Hopper 的 Tensor Core 在 FP8 模式下只保留乘积的最高 13 位尾数,累加到所谓“FP22”寄存器(1 符号位 + 8 指数位 + 13 尾数位)。对于大模型训练中的长序列和深网络,这种低位累加会放大数值误差。
第二,细粒度量化引入大量反量化开销。 tile-wise / block-wise 量化需要在 Tensor Core 和 CUDA Core 之间频繁搬运 scaling factor,做部分和的反量化乘法。这种数据搬运降低了计算效率,也增加了编程复杂度。
论文给出的建议是:未来硬件应支持可配置的累加精度(最好到 FP32),并在 Tensor Core 内部原生支持带 group scaling 的矩阵乘法——让反量化在 Tensor Core 内部完成,而不是把部分和搬到 CUDA Core。这个建议直接指向了 NVIDIA Blackwell 的 microscaling 数据格式,说明作者对下一代硬件有清晰预期。
2.3 LogFMT:一个被“GPU 带宽不足”杀死的优雅想法
LogFMT 是论文中一个很有意思但被放弃的尝试。它的基本思想是:把激活值从线性空间映射到对数空间,使得分布更均匀,从而用更少的 bit 达到与 FP8 相当甚至更好的精度。
论文给出的实现细节是:对每个 1×128 的 tile,取绝对值后求对数,找到最小值和最大值,把最小值编码为 S.00...01,最大值编码为 S.11...11,中间按 step 均匀划分。论文在约 7B 参数的稠密模型上验证,LogFMT-8Bit 比 E4M3/E5M2 精度更好;LogFMT-10Bit 接近 BF16 combine 阶段的效果。
但 LogFMT 最终没有被采用,原因是:
“Due to insufficient GPU bandwidth for log/exp operations and excessive register pressure during encode/decode, if encode/decode operations are fused with all-to-all communication, the overhead can be substantial (50%∼100%).”
这话说得很直白:不是格式不好,而是 Hopper GPU 上没有足够的 log/exp 计算带宽和寄存器预算来实时编解码。 这也揭示了 DeepSeek-V3 的一个核心取舍哲学:如果硬件不能原生支持某个优化,即使理论上再优雅,也会因 overhead 过大而被砍掉。
2.4 低精度驱动设计的真正价值
FP8 + LogFMT 这一段给我的最大启示是:DeepSeek-V3 把“低精度”从推理阶段的节省内存手段,提升到了训练阶段的设计核心。这不是简单的量化,而是让模型架构、训练框架、通信格式、硬件能力四者围绕精度-性能 trade-off 做协同设计。
但代价也很明显:
- 调试难度剧增:FP8 训练中的数值不稳定问题比 BF16 更难定位;
- 框架绑定加深:DeepGEMM 等定制 kernel 成为刚需,团队必须具备底层 CUDA 能力;
- 迁移性受限:FP8 训练方案对 NVIDIA Hopper/Blackwell 架构有强依赖,向其他硬件迁移成本高。
技术支柱三:H800 互联与并行策略——在带宽缺口上做文章
3.1 H800:一台被出口管制“削过”的 Hopper
要理解 DeepSeek-V3 的所有通信优化,必须先理解 H800 这台机器的特殊性。论文 Figure 2 展示了 H800 节点内部结构:8 张 H800 SXM5 GPU,每张通过 PCIe Switch 连接一张 ConnectX-7 400Gbps IB NIC,GPU 之间通过 NVLink Switch Chip 互联。
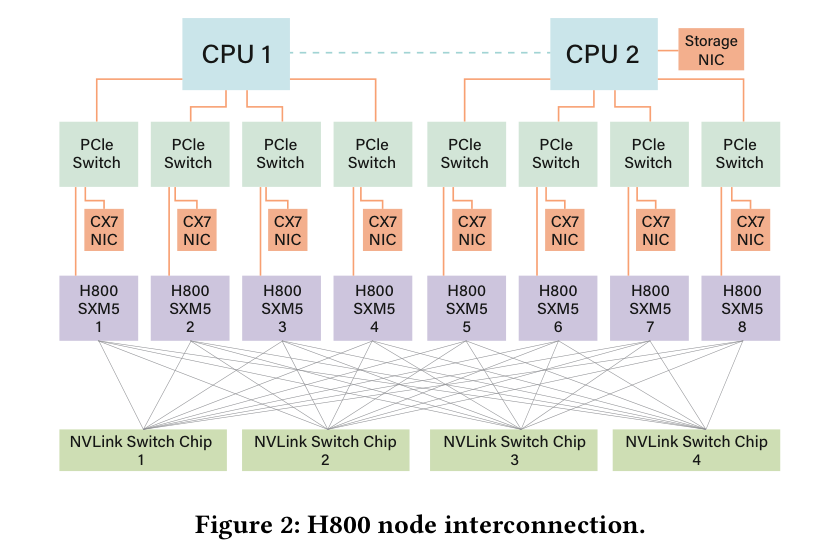
Figure 2 解读:这张图最关键的信息不是“8 卡 8 网卡”这种表面配置,而是节点内外的带宽不对称。H800 SXM 的 NVLink 带宽从 H100 的 900 GB/s 降到了 400 GB/s;而节点外通过 8 张 400Gbps IB NIC 出网,每张 NIC 单向有效带宽约 40–50 GB/s。换句话说,节点内 NVLink 的有效带宽(约 160 GB/s 可用)与节点外 IB 的有效带宽(约 40 GB/s)之间存在约 4:1 的差距。这种差距是 DeepSeek-V3 所有路由和并行策略设计的起点。
论文中的原话是:
“Specifically, the NVLink bandwidth in H800 SXM nodes is reduced from 900 GB/s to 400 GB/s. This significant reduction in intra-node scale-up bandwidth presents a challenge for high-performance workloads. To compensate, each node is equipped with eight 400G InfiniBand (IB) CX7 NICs, enhancing scale-out capabilities to mitigate the bandwidth deficit.”
注意这里的措辞:“to compensate”(为了补偿)。H800 不是 DeepSeek 主动选择的理想平台,而是需要被补偿的对象。
3.2 并行策略:避开 TP,强化 PP 与 EP
针对 H800 的带宽结构,论文明确了三条并行策略:
- 避免训练时使用 Tensor Parallelism(TP):TP 需要高频的节点内 all-reduce,对 NVLink 带宽极其敏感。H800 的 NVLink 被削弱后,TP 的效率大幅下降;
- 使用 DualPipe 做 Pipeline Parallelism(PP):DualPipe 把前向、反向计算与 MoE 通信重叠,减少 pipeline bubble;
- 加速 Expert Parallelism(EP):EP 是 MoE 训练的必需品,但会带来跨节点 all-to-all。H800 靠 8 张 IB NIC 把 EP 通信带宽推到 40 GB/s 以上,配合开源的 DeepEP 库实现高效调度。
这三条策略有一个共同特征:它们都把通信压力从节点内 NVLink 转移到节点外 IB,或者通过重叠隐藏通信延迟。 这是典型的“用软件编排弥补硬件带宽不足”的思路。
3.3 Node-Limited Routing:用模型约束换网络带宽
Node-Limited Routing 是 DeepSeek-V3 最具工程巧思的设计之一。它的核心观察是:如果每个 token 的 8 个目标专家均匀分布在 8 个节点上,那么每个 token 都需要通过 IB 发送 8 份;但如果目标专家集中在更少的节点上,就可以利用 NVLink 在节点内转发,减少 IB 流量。
具体做法:把 256 个 routed expert 分成 8 组,每组 32 个专家部署在一个节点上;路由算法确保每个 token 最多被分发到 4 个节点。这样,原本可能需要 8 次 IB 传输的 token,现在最多只需要 4 次,IB 流量被有效去重。
论文给出的数字是:NVLink 有效带宽约 160 GB/s,IB 有效带宽按保守估计 40 GB/s。通过 Node-Limited Routing,IB 通信量从“与目标专家节点数成正比”变成“与受限后的节点数 M 成正比”,其中 M ≤ 4。
这个设计的本质是把通信复杂度从网络层转移到模型层——用路由约束换取网络效率。但代价也很明显:
第一,它限制了专家分布的灵活性。 如果某些领域的 token 天然需要访问更多专家,路由约束会人为降低模型容量利用率; 第二,它让通信 kernel 变得更复杂。 节点内 NVLink 转发与节点外 IB 传输的混合路径,要求通信库同时管理两种不同延迟和带宽的链路; 第三,它对负载均衡提出更高要求。 限制节点数意味着必须保证各节点上的专家负载相对均衡,否则会出现某些节点 IB 拥塞而另一些节点空闲的情况。
3.4 训练与推理的差异:为什么推理要全走 NIC RDMA
论文中有一个容易被忽略但很重要的细节:在训练时,H800 上最多有 20 个 SM 被用于通信相关操作(QP/WQE 填充、NVLink 转发、数据类型转换等);而在在线推理中,为了最大化计算效率,DeepSeek 选择让 EP all-to-all 完全通过 NIC RDMA 完成,避免 SM 资源竞争。
这说明同一个模型在不同阶段的最优通信策略是不同的。训练可以容忍用 SM 做转发和去重,因为训练更关注整体吞吐;推理则必须把 SM 让给计算 kernel,因为推理对 TPOT(Time Per Output Token)更敏感。
3.5 Scale-Up 与 Scale-Out 收敛:一个面向未来的呼吁
论文 Section 4.4 明确呼吁未来硬件应把 scale-up(节点内)和 scale-out(节点间)通信整合到统一框架中。作者列出了四条具体建议:
- 统一网络适配器:NIC 或 I/O Die 同时连接 scale-up 和 scale-out 网络,支持基于策略的转发;
- 专用通信协处理器:把网络流量处理从 GPU SM 卸载到独立 I/O Die;
- 灵活的转发/广播/归约机制:在 scale-up 和 scale-out 之间支持硬件级 multicast 和 reduce;
- 硬件同步原语:用 acquire/release 语义替代 RDMA completion event,降低软件同步开销。
这些建议的潜台词是:当前 GPU 的通信仍然靠 SM 和 CPU 代理打补丁,未来应该把通信当作一等公民纳入芯片设计。 这既是 DeepSeek 的真实痛点,也是整个行业(UEC、UALink、UB-Mesh 等)正在探索的方向。
技术支柱四:MPFT 多平面胖树——用拓扑简化换成本
4.1 为什么需要多平面?
大模型训练集群的网络拓扑通常有两种选择:
- 三层胖树(FT3):规模大(可达 65,536 GPU),但成本高、延迟高、交换机数量多;
- 两层胖树(FT2):成本低、延迟低,但传统单平面设计下规模受限。
DeepSeek-V3 采用的 Multi-Plane Fat-Tree(MPFT) 试图打破这个 trade-off:每个节点有 8 张 IB NIC,每张 NIC 属于一个独立的网络平面;每个平面内部是一个两层胖树,8 个平面并行工作。这样,两层网络就能支撑 16,384 GPU 的集群规模。
论文 Figure 3 展示了 MPFT 的物理结构:每个 GPU-NIC 对绑定到一个平面,跨平面流量需要通过节点内的 NVLink/PCIe 转发。
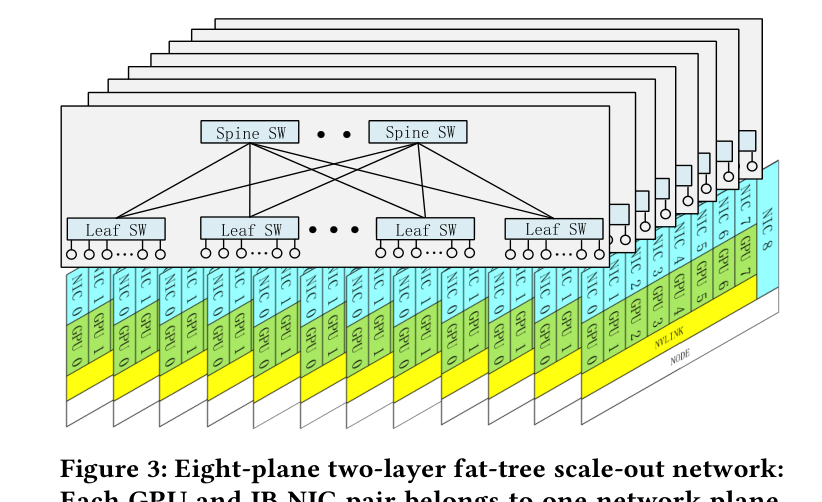
Figure 3 解读:这张图用透视方式画了 8 个并行的两层胖树平面。每个平面有自己的 Leaf Switch 和 Spine Switch;节点底部的 GPU 和 NIC 按颜色区分所属平面。这种设计的直观好处是:每个平面只需要处理 1/8 的总流量,因此可以用更少的交换机端口和更简单的两层拓扑达到更大规模。坏处也很明显:跨平面通信必须“绕道”节点内部,增加了延迟和实现复杂度。
4.2 成本对比:MPFT 如何用 FT2 的价格接近 FT3 的规模
论文 Table 3 给出了清晰的成本对比:
| 拓扑 | Endpoints | Switches | Links | Cost [M$] | Cost/Endpoint [k$] |
|---|---|---|---|---|---|
| FT2(单平面两层胖树) | 2,048 | 96 | 2,048 | 9 | 4.39 |
| MPFT(八平面两层胖树) | 16,384 | 768 | 16,384 | 72 | 4.39 |
| FT3(单平面三层胖树) | 65,536 | 5,120 | 131,072 | 491 | 7.5 |
| Slim Fly | 32,928 | 1,568 | 32,928 | 146 | 4.4 |
| Dragonfly | 261,632 | 16,352 | 384,272 | 1,522 | 5.8 |
关键数字:MPFT 用两层网络实现了 16,384 个端点,每端点成本与 FT2 相同(4.39 k$),远低于 FT3 的 7.5 k$。 这意味着在 DeepSeek 的实际部署规模(约 2,000 GPU)下,MPFT 的成本优势和延迟优势都非常明显。
4.3 理想与现实:Figure 4 揭示的 NIC 能力缺口
论文 Figure 4 描绘了作者心目中的“理想多平面网络”:每张 NIC 有多个物理端口,分别连接到不同平面,但从用户视角看仍然是一个逻辑接口;单个 QP(Queue Pair)可以同时使用所有端口收发数据,NIC 原生支持乱序放置(out-of-order placement)。
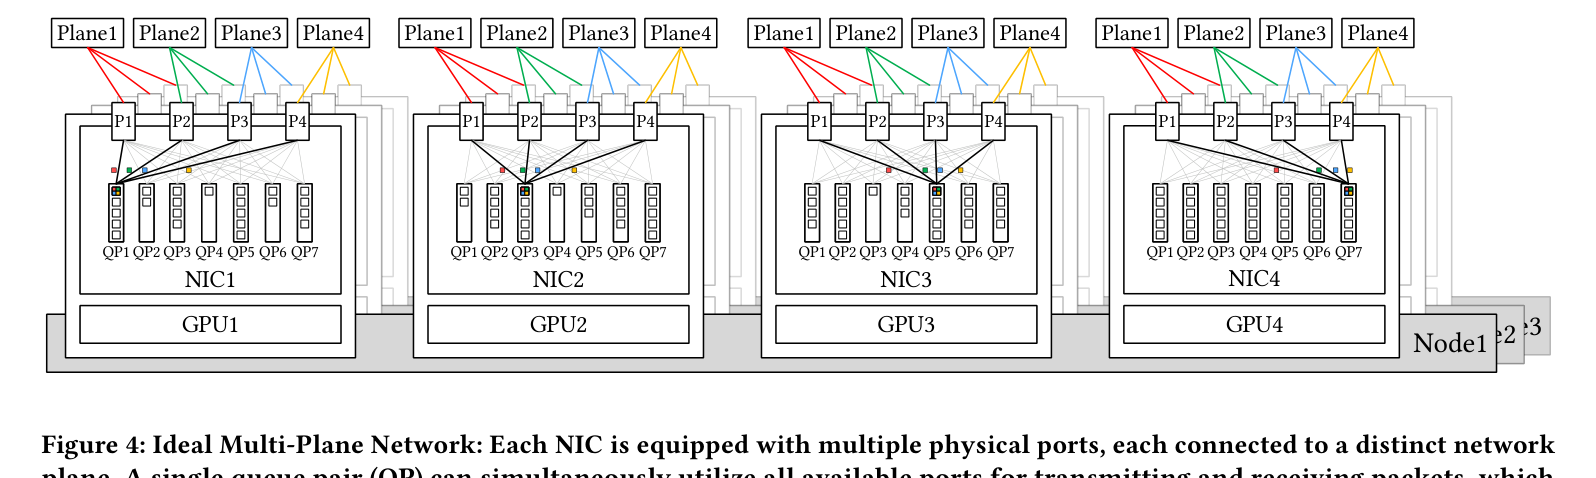
Figure 4 解读:这张图的本质是“把多个物理平面抽象成一个逻辑接口”。NIC1 的 P1-P4 分别连到 Plane1-Plane4,QP1-QP7 可以同时分散到所有端口上传输。这种设计需要 NIC 支持 packet spraying 和乱序重组。作者提到 InfiniBand ConnectX-8 已原生支持四平面,说明这是可预见的演进方向,而 H800 上使用的 ConnectX-7 还做不到这一点。
ConnectX-7 的不足导致 DeepSeek 实际部署的 MPFT 并不完全理想:跨平面通信需要节点内转发,引入额外延迟。论文对此表示:
“Furthermore, due to the current limitations of IB ConnectX-7, our deployed MPFT network does not fully realize the envisioned architecture.”
这句话非常坦诚——多平面架构的潜力被当前 NIC 硬件能力限制了。
4.4 性能验证:MPFT 与 MRFT 打平
论文 Figure 5、6、7 给出了 MPFT 与单平面 Multi-Rail Fat-Tree(MRFT)的性能对比。结果显示:
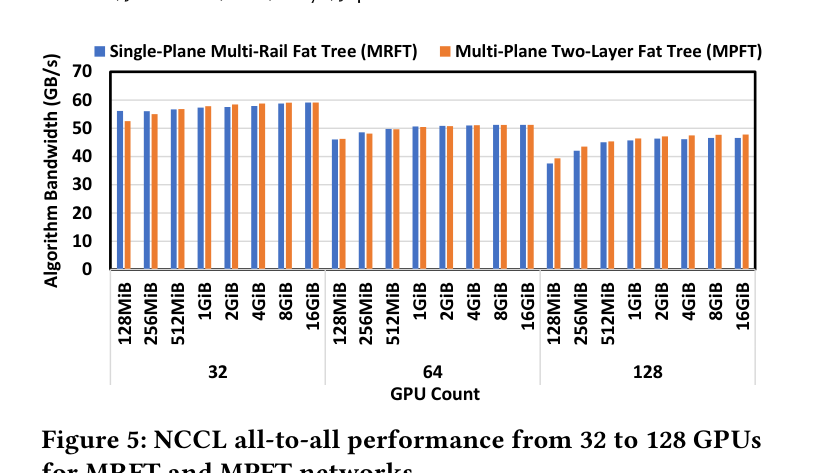
Figure 5 解读:横轴是消息大小(128 MiB 到 16 GiB)和 GPU 数量(32/64/128),纵轴是算法带宽(GB/s)。蓝色柱是 MRFT,橙色柱是 MPFT。在绝大多数配置下,两者带宽几乎重合。这说明 MPFT 通过 NCCL PXN 机制(利用 NVLink 做节点内转发)成功弥补了跨平面带来的潜在性能损失。
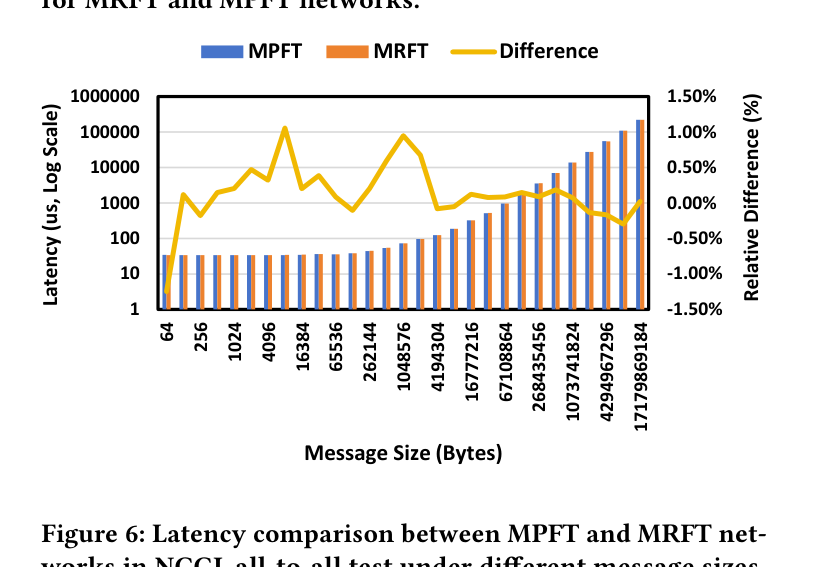
Figure 6 解读:横轴是消息大小(对数刻度),左侧纵轴是延迟(微秒,对数刻度),右侧纵轴是相对差异百分比。黄色线(Difference)显示 MPFT 与 MRFT 的延迟差异基本在 ±1% 以内。对于大模型训练中常见的小消息 all-to-all,两者性能几乎无差别。
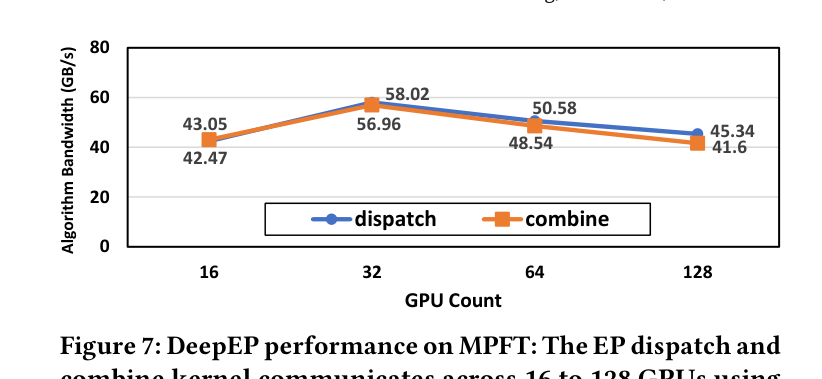
Figure 7 解读:这是 DeepEP 在 MPFT 上的实测带宽。横轴是 GPU 数量(16 到 128),纵轴是算法带宽。dispatch(蓝色)和 combine(橙色)在 32 GPU 时达到峰值约 58 GB/s,在 128 GPU 时仍保持在 41–45 GB/s。考虑到 400Gbps NIC 的理论单向带宽约 50 GB/s,这个成绩已经接近物理极限。
Table 4 进一步给出了真实训练指标对比:
| 指标 | MPFT | MRFT |
|---|---|---|
| tokens/day (B) | 272.80 | 272.52 |
| time/step (s) | 19.926 | 19.946 |
| MFU (causal) | 38.94% | 38.90% |
| MFU (non-causal) | 43.73% | 43.68% |
MFU 接近 39%(causal)/ 44%(non-causal),且 MPFT 与 MRFT 差异在测量误差范围内。 这个数据说明,MPFT 在成本更低的同时,性能没有明显损失。
4.5 “不是免费的”:MPFT 的隐性代价
第一,运维复杂度显著增加。 8 个独立平面意味着 8 套交换机、8 套路由策略、8 套故障域。任何一个平面出问题,都需要快速定位到具体平面和端口;
第二,跨平面流量需要节点内转发。 虽然 Figure 5/6 显示性能损失很小,但这依赖于 NCCL PXN 和节点内 NVLink。如果节点内互联带宽进一步下降(比如某些低配 H800 机型),跨平面延迟会急剧恶化;
第三,MPFT 是 MRFT 的子集,依赖 NCCL 生态。 论文明确说 MPFT 属于 MRFT 架构的一个子集,因此可以利用 NVIDIA 和 NCCL 对 Multi-Rail 网络的现有优化。这也意味着:如果离开 NVIDIA 生态(比如使用国产芯片或 RoCE 交换机),MPFT 的优势可能无法直接复现;
第四,规模上限仍然受限于平面数。 MPFT 用 8 个平面把两层胖树推到 16K GPU;如果需要更大规模,仍然要回到三层拓扑或其他拓扑(如 Slim Fly、Dragonfly)。
技术支柱五:低延迟网络与 IBGDA——把 CPU 踢出关键路径
5.1 IB 还是 RoCE?延迟数字说明一切
论文 Table 5 给出了 64B 数据在三种链路上的端到端延迟:
| 链路层 | 同 Leaf | 跨 Leaf |
|---|---|---|
| RoCE | 3.6 μs | 5.6 μs |
| InfiniBand | 2.8 μs | 3.7 μs |
| NVLink | 3.33 μs | - |
IB 在延迟上明显优于 RoCE,这也是 DeepSeek-V3 选择 IB 做训练网络的原因。但论文也指出 IB 的两个限制:
- 成本高:IB 交换机和 NIC 显著贵于 RoCE;
- 端口密度低:IB 交换机通常 64 口,而 RoCE 交换机可达 128 口,限制了单集群规模。
5.2 RoCE 的改进建议:从 ECMP 到自适应路由
论文对 RoCE 的态度是“可以用,但需要改造”。Figure 8 展示了不同路由策略下 RoCE 的 AllGather 和 ReduceScatter 带宽:
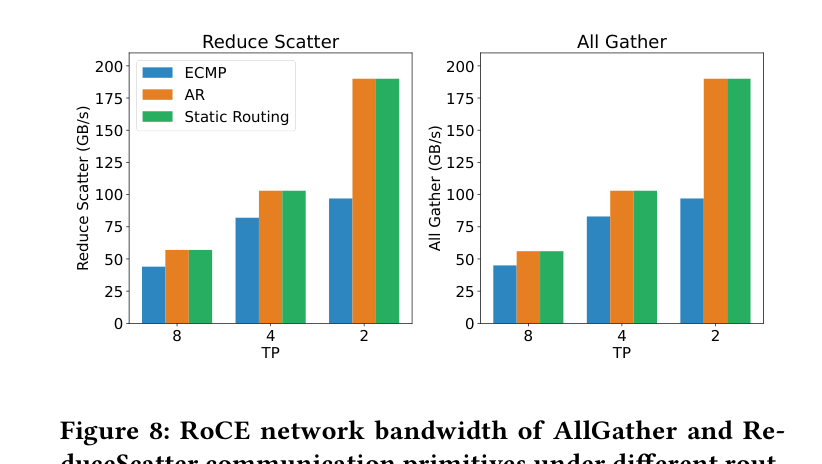
Figure 8 解读:横轴是 TP(Tensor Parallelism)维度,从 8 降到 2 意味着跨节点流量增加;纵轴是带宽(GB/s)。蓝色(ECMP)在 TP=2 时性能明显劣于橙色(Adaptive Routing,AR)和绿色(Static Routing)。这说明在 LLM 训练这种大流、少随机性的流量模式下,默认 ECMP 的哈希极化会严重降低有效带宽;而 AR 通过动态 packet spraying 能显著改善负载均衡。
论文建议 RoCE 交换机向三个方向改进:
- 专用低延迟 RoCE 交换机:去掉不必要的以太网特性,参考 Cray Slingshot 和 Broadcom AIFH;
- 自适应路由(AR):用 packet spraying 替代 ECMP,避免哈希极化;
- 更好的流量隔离与拥塞控制:支持 VOQ(Virtual Output Queuing)和可编程拥塞控制(PCC/RTTCC)。
这些建议再次体现了论文的核心视角:网络问题最终要靠端-网协同解决,而不是指望单一层次的优化。
5.3 IBGDA:GPU 直接敲 NIC 的门铃
IBGDA(InfiniBand GPUDirect Async)是 DeepSeek-V3 用来降低网络延迟的关键技术。传统 RDMA 流程中,GPU 准备好数据后需要通知 CPU 代理线程,由 CPU 填充 Work Request(WR)并写 NIC 的 doorbell 寄存器;这个 CPU 介入的过程会带来数十微秒的额外开销。
IBGDA 允许 GPU 直接填充 WR 并写 doorbell MMIO 地址,把整个控制面搬到 GPU 内部。论文说:
“By managing the entire control plane within the GPU, IBGDA eliminates the significant latency overhead associated with GPU-CPU communication.”
对于 EP 这种需要发送大量小包的 all-to-all 通信,IBGDA 还可以利用 GPU 的多线程并行分发 WR,避免控制面处理器成为瓶颈。DeepEP 等库已经广泛利用 IBGDA 取得了显著性能提升。
5.4 低延迟网络的真正价值:推理阶段被放大
论文 Section 2.3.2 做了一个非常直观的估算:
- 在 H800 + CX7 400Gbps IB 上,EP 每层两个 all-to-all 的通信时间约为 241.92 μs,61 层累计约 14.76 ms,对应理论上限约 67 tokens/s;
- 如果换成 GB200 NVL72(900 GB/s 单向 scale-up 带宽),每层通信时间降到 13.44 μs,61 层累计约 0.82 ms,理论上限可达 1,200 tokens/s。
这两个数字的差距是数量级的。论文对此的评价是:
“This calculation vividly illustrates the transformative potential of high-bandwidth scale-up networks in accelerating large-scale model inference.”
这里的关键词是 “scale-up networks”——不是 scale-out,而是节点内高带宽互联。这也是 DeepSeek-V3 整个硬件反思中最无奈的结论:它的推理速度上限主要被 H800 的 NVLink 带宽锁死了。
技术支柱六:未来硬件方向——DeepSeek 的“愿望清单”
6.1 从“补短板”到“许愿单”
论文第六节花了大量篇幅讨论未来硬件方向。与其他论文中常见的泛泛展望不同,DeepSeek 的每一条建议都带着鲜明的“痛点驱动”特征——它们几乎都是当前 H800 集群中真实遇到的限制。
6.2 更精确的低精度计算单元
论文对 FP8 累加精度的批评已经相当直接。作者建议未来硬件支持可配置累加精度,并在 Tensor Core 内部原生支持 group scaling。这实际上是在呼吁:低精度不应该只是“位数减少”,而应该是一套完整的“精度-性能-可编程性”协同设计。NVIDIA Blackwell 的 microscaling 格式(如 MXFP8)已经朝这个方向迈出了一步,但论文暗示这还远远不够——尤其是当训练规模继续扩大、序列继续变长时,低位累加的数值误差会被网络深度放大。
6.3 Scale-Up 与 Scale-Out 收敛
这是论文最核心的硬件呼吁之一。当前 H800 的节点内 NVLink 和节点外 IB 是两个独立域:NVLink 负责 GPU-GPU 高速通信,IB 负责跨节点 RDMA。两者有不同的编程模型、不同的拥塞控制、不同的故障恢复机制。DeepSeek 不得不同时在两个域上做优化(Node-Limited Routing 本质上就是在两个域之间做流量调度)。
论文建议未来硬件通过统一网络适配器、专用通信协处理器、灵活转发/广播/归约机制、硬件同步原语四个方面实现收敛。这个愿景与 UEC(Ultra Ethernet Consortium)、UALink、华为 UB-Mesh 等开放互联倡议方向一致——本质上都是想把 GPU 集群的通信从“分层补丁”变成“统一内存语义”。
6.4 更智能的网络:自适应路由与在网计算
论文对 RoCE 的建议(AR、VOQ、可编程 CC)和对 IB 的建议(IBGDA 普及)共同指向一个判断:未来 AI 网络不能只是“带宽管道”,而必须是“可感知流量特征的智能 fabric”。
在网计算(In-Network Computation)是论文中一个值得注意的方向。作者指出,EP 的 dispatch 阶段类似小规模 multicast,combine 阶段类似小规模 reduction;如果网络硬件能原生支持包复制和在网归约,就可以大幅减少 GPU 端的通信开销。但论文也承认,由于 EP combine 的归约范围小、负载不均衡,在网聚合的灵活性实现起来有挑战。
6.5 内存-centric 架构
论文最后把话题拉回到内存墙。作者建议两条路线:
- DRAM-Stacked Accelerators:把 DRAM Die 垂直堆叠在逻辑 Die 上,获得超高带宽和超低延迟,但容量受限于堆叠层数;
- System-on-Wafer(SoW):用晶圆级集成最大化计算密度和内存带宽。
这两条路线都不是新鲜概念(Cerebras、SeDRAM 等已有探索),但论文把它们放在 MoE 推理的场景下讨论,有了新的意义:MoE 推理是内存带宽密集型 workload,如果能把专家参数放在超高带宽的近计算内存中,推理速度的上限会被显著抬高。
6.6 鲁棒性与可观测性
论文 Section 6.1 讨论了一个容易被忽视但至关重要的问题:大规模集群的鲁棒性。作者列举了三种风险:
- 互联故障:IB/NVLink 间歇性断连,对 EP 这种通信密集型 workload 尤其致命;
- 单点硬件故障:节点崩溃、GPU 故障、ECC 内存错误,可能导致长训练任务重启;
- 静默数据损坏(Silent Data Corruption):ECC 无法检测的多 bit 翻转或计算错误,可能污染模型质量。
论文建议硬件厂商提供更强大的错误检测机制(如 checksum、硬件冗余校验)和更完整的诊断工具包。这反映了 DeepSeek 在生产实践中确实遇到过这些问题——否则不会在 ISCA 论文中专门辟出一节来呼吁。
题外话:H800 的“出口管制辩证法”
读到这篇论文时,我一直在想一个略带讽刺的问题:如果没有出口管制,DeepSeek-V3 还会是今天这个样子吗?
答案很可能是:不会。如果 DeepSeek 能买到满血 H100 或 GB200,它大概率不会花这么大精力去做 MLA、Node-Limited Routing、MPFT 这些“补丁式”优化;它会像 OpenAI、Meta 一样,用更强的 scale-up 带宽和更大的集群规模暴力堆叠。
但出口管制逼出了另一种创新路径:在硬件边界被锁死的情况下,把模型和软件做到极致。 这有点像资源受限下的算法研究——有时候约束反而能激发更优雅的解法。🤣
当然,这种“辩证法”不能反过来为出口管制辩护。DeepSeek 的效率神话背后,是中国 AI 团队在被切断最先进供应链后的生存策略。对于国内同行来说,更值得学习的不是“如何在 H800 上生存”,而是“如何在任何约束下找到局部最优解”。
组织归因:为什么 DeepSeek 会做出这些取舍
7.1 真正的决定性原因,藏在组织约束里
读到这一节之前,我们可能会把 DeepSeek-V3 的创新归因于“算法团队更强”或“更懂底层优化”。这些解释都没错,但都回避了一个更根本的问题:Google、Meta、OpenAI、阿里、字节等公司也有世界级的算法和工程团队,为什么它们的公开方案与 DeepSeek 如此不同?
个人认为,回答这个问题的关键在于组织架构与外部依赖关系。DeepSeek-AI 的核心约束可以概括为以下几点:
- 它是一家模型公司,不是云厂商,也不是芯片公司。 这意味着它无法像 Google 那样自研 TPU 和光交换,无法像 Meta/阿里那样大规模定制 RoCE 交换机,也无法像 NVIDIA 那样定义芯片架构;
- 它采购的是受出口管制的 NVIDIA H800 GPU。 H800 在 2023 年 3 月被 NVIDIA 作为 H100 的“合规版”推出,2023 年 10 月又被加入美国出口管制清单。DeepSeek 在管制收紧前采购了这批芯片,但无法获得 H100 的满血 NVLink 带宽,更无法获得后续 Blackwell/GB200 系列;
- 它必须使用商用 IB/RoCE 网络设备。 网络侧无法像 Google ICI 或 Meta 的定制 RoCE 那样做深度硬件改造,只能在 NCCL、IB Verbs、RDMA 等标准化接口上做软件优化;
- 它背后有量化对冲基金幻方(High-Flyer)的资源支持。 这给了它足够的算力储备和长期投入能力,但也意味着它必须在既有硬件上把效率做到极致,而不是等待下一代硬件;
- 它是一家高度垂直整合的模型实验室。 DeepSeek 的算法团队、训练框架团队、通信库团队、基础设施团队可以在同一组织内快速迭代。这种结构让它能够把模型约束(如 Node-Limited Routing)直接写入训练代码,把通信优化(如 DeepEP)直接匹配到模型需求,而不是像云厂商那样需要协调多个独立团队。
这些约束共同塑造了一个清晰的技术偏好:凡是外部依赖(芯片、网络)不能改变的,就把复杂度搬到内部可控的软件与模型设计中。
7.1.1 开源策略也是组织策略的延伸
论文中多次提到 DeepSeek 开源的工具:DeepGEMM、DeepEP、DualPipe、3FS、profile-data 等。这种开源行为不能简单理解为“做公益”,它实际上是组织约束下的理性选择:
- 降低生态依赖:通过开源通信库和 kernel,DeepSeek 可以影响社区向有利于自己的方向演进,减少对 NVIDIA 单一生态的依赖;
- 吸引人才与反馈:开源代码是最高效的招聘广告和技术交流方式,尤其是当公司无法像 Google/Meta 那样提供顶级硬件平台时;
- 建立事实标准:如果足够多的团队使用 DeepEP 和 DeepGEMM,这些库中的设计选择(如 FP8 量化粒度、EP all-to-all 的调度模式)会成为事实标准,反过来降低 DeepSeek 自身的维护成本。
从康威定律角度看,DeepSeek 的开源布局也反映了它的组织结构:算法、训练、通信、基础设施团队高度内聚,因此能够把内部工具快速产品化并开源。这与云厂商的开源策略有本质不同——云厂商开源通常是为了吸引客户上云,而 DeepSeek 开源是为了扩大自己的技术杠杆。
7.2 决策点对比:复杂度归属如何转移
| 决策点 | 传统/大厂方案 | DeepSeek-V3 方案 | 复杂度归属变化 |
|---|---|---|---|
| KV Cache 压缩 | 用 HBM 扩容或 GQA | MLA 低秩投影 | 从硬件内存容量 → 模型结构 |
| 模型容量扩展 | 稠密模型 + 更多 GPU | DeepSeekMoE 稀疏激活 | 从计算量 → 路由与负载均衡 |
| 训练精度 | BF16 / FP32 | FP8 + 细粒度量化 | 从硬件累加精度 → 训练框架与消融验证 |
| 节点间通信 | 依赖高带宽 scale-up | Node-Limited Routing | 从网络带宽 → 模型路由约束 |
| 网络拓扑 | FT3 三层胖树 | MPFT 两层多平面 | 从交换机数量 → 平面运维复杂度 |
| 控制面延迟 | CPU 代理触发 RDMA | IBGDA GPU 直接 doorbell | 从 CPU 调度 → GPU 内核与通信库 |
这张表揭示了一个共同模式:DeepSeek 把原本由硬件或外部基础设施承担的复杂度,转移到了自己能够控制的算法、模型和软件层面。 这是典型的“自给自足”架构选择。
7.3 横向厂商对比:不同组织约束下的不同选择
Google:自研 TPU 和光交换(ICI),可以通过定制硬件把 scale-up 和 scale-out 统一到一个编程模型里。Google 的复杂度主要在芯片和集群架构;
Meta / 阿里:作为云厂商/超大规模互联网公司,它们可以定制 RoCE 交换机、开发自己的拥塞控制算法(如阿里的 HPCC、Solar-RDMA)、自研通信库(ACCL)。它们的复杂度主要在端网协同和网络运维;
OpenAI:依赖 Microsoft Azure 等云厂商提供基础设施,因此倾向于把复杂度转移到端侧(如 MRC 协议、静态 SRv6、ClusterMapper),减少对交换机网络的依赖;
DeepSeek:比 OpenAI 更缺乏基础设施控制权(无法租用 Azure 级别的定制网络),又比 Google/Meta 更缺乏芯片定制能力。因此它只能选择最“向内求”的路线:改模型、改通信库、改训练框架。
这些路线没有绝对的优劣之分,它们各自在自己的组织约束下都是合理的。DeepSeek-V3 的特殊之处在于,它证明了即使硬件约束非常严苛,软件-模型协同设计仍然可以挤出巨大的效率空间。
7.4 一段值得品味的原文
论文在谈到未来硬件时写道:
“We strongly recommend that future hardware should integrate intra-node (scale-up) and inter-node (scale-out) communication into a unified framework. By incorporating dedicated co-processors for network traffic management and seamless forwarding between NVLink and IB domains, such designs can reduce software complexity and maximize bandwidth utilization.”
这话说得很客气,但潜台词非常明确:当前 H800 的 scale-up 和 scale-out 是割裂的,DeepSeek 不得不用复杂的软件(Node-Limited Routing、DeepEP、DualPipe)来填补这个鸿沟。 如果未来硬件能把 NVLink 和 IB 统一到一个框架里,DeepSeek 的很多问题会自然消失。
7.5 自问自答:为什么 DeepSeek 会这样选
为什么用 MLA 而不是继续扩 HBM? 因为 HBM 扩容的速度跟不上模型规模增长,而 DeepSeek 无法控制 HBM 供应链。
为什么用 MoE 而不是稠密模型? 因为 H800 数量有限,必须用稀疏激活把每 token 计算量压下来。
为什么敢用 FP8 训练? 因为 Hopper 的 FP8 算力是 BF16 的两倍,而 DeepSeek 有足够强的算法和工程团队做精度验证。
为什么做 Node-Limited Routing? 因为 H800 的 NVLink 被削弱,IB 带宽又不足,必须用路由约束减少跨节点流量。
为什么做 MPFT? 因为 IB 交换机端口密度低、成本高,必须用多平面两层拓扑在规模和成本之间取得平衡。
每一个“为什么”都不是单纯的技术问题。它们是 DeepSeek 在自己的组织约束、外部依赖关系、业务压力和硬件现实里,找到的局部最优解。
批判与代价:这套方案丢掉了什么
8.1 通用性损失
DeepSeek-V3 的几乎所有优化都建立在 MoE + H800 + IB 的组合上。如果把模型换成稠密模型、把 GPU 换成满血 H100/GB200、把网络换成 RoCE,很多取舍就不再成立:
- MLA 的 RoPE 兼容性对推理引擎有侵入性;
- Node-Limited Routing 依赖 MoE 的稀疏路由结构;
- DeepEP 针对 IB RDMA 优化,向 RoCE 迁移需要重写;
- MPFT 依赖 NCCL 对 Multi-Rail 的支持。
8.2 工程门槛极高
FP8 训练、DeepEP、DualPipe、MLA 的推理优化,每一项都需要顶尖的底层工程能力。论文轻描淡写地提到“我们开源了 DeepGEMM 和 DeepEP”,但这背后是大量的人力投入和对 NVIDIA 软硬件栈的深入理解。
8.3 调试与可观测性困难
低精度训练中的数值问题、MoE 路由崩塌、多平面网络中的跨平面拥塞,这些问题在大规模集群下都很难定位。论文本身也承认,当前硬件在错误检测和诊断工具方面存在不足。
8.4 对下一代硬件的依赖风险
论文花了一整节讨论未来硬件方向,本质上是在说:如果 Blackwell/GB200 能解决 FP8 累加精度、scale-up/scale-out 统一、NIC 多平面等问题,DeepSeek 当前的很多“补丁”就不再必要。 这种“补丁式创新”的保鲜期可能很短。
8.5 数据可复现性与外部验证的缺失
论文中大量关键数字(如训练成本、MFU、推理 TPS)来自 DeepSeek 自己的集群和代码,外部团队很难独立验证。尤其是 MFU 的计算口径(causal vs non-causal)不同团队可能得出差异很大的数字。这并不是说论文数据不可信,而是提醒读者:任何内部性能数据都需要结合具体实现和测试条件来理解。
8.6 泛化到其他芯片架构的不确定性
MLA、FP8、DeepEP 都是对 NVIDIA Hopper 生态深度优化的结果。如果要迁移到华为昇腾、AMD MI300、Intel Gaudi 等硬件,很多假设(如 Tensor Core 的 FP8 累加行为、IB Verbs 的可用性、NVLink 的替代方案)都需要重新验证。对于正在建设国产算力生态的团队,直接移植 DeepSeek-V3 的工程方案可能比重新设计更困难。
适用边界与行业借鉴
9.1 舒适区:四个前提条件
条件一:模型必须是稀疏 MoE 架构。 稠密模型无法享受 DeepSeekMoE 的计算-参数解耦优势,也无法有效使用 Node-Limited Routing。
条件二:团队必须具备模型、通信库、训练框架的端到端闭环能力。 单纯使用开源框架无法复现 MLA、FP8、DeepEP 等优化。
条件三:网络必须是 IB 或经过深度优化的 RoCE。 MPFT 和 DeepEP 对 RDMA 语义和网络拓扑有强假设,普通以太网无法直接支持。
条件四:愿意接受一定的模型结构约束。 Node-Limited Routing、FP8、MLA 都会限制模型设计的自由度。
全部满足可直接借鉴;有一个不满足,就要谨慎评估。
9.2 三类不适配场景
场景一:小型集群或推理为主的业务。 DeepSeek-V3 的优化很多是为大规模训练设计的。如果集群只有几十到几百卡,或者业务以推理为主,MLA 和 MoE 的收益会被实现复杂度抵消。
场景二:采购的是满血 H100/GB200 的团队。 如果硬件瓶颈不是 NVLink 和 IB 带宽,那么 Node-Limited Routing、MPFT 等优化就没有必要,反而可能引入不必要的约束。
场景三:缺乏底层 CUDA/网络工程能力的团队。 FP8 训练和 DeepEP 级别的通信优化不是普通算法团队能驾驭的,强行模仿可能导致训练不稳定或性能不升反降。
9.3 分群体建议
超大型云厂商(如阿里、腾讯、华为云):
- 第一,继续投资自研网络芯片和 RoCE 交换机,把端网协同做深;
- 第二,关注 UEC/UALink/UB 等开放互联标准,避免被 NVIDIA 生态完全锁定;
- 第三,学习 DeepSeek 的“端侧最大化”思路,但不必复制其具体约束。
AI 头部公司(如字节、百度、月之暗面、MiniMax):
- 第一,评估 MoE + MLA 是否适合自己的模型路线,尤其是长上下文和推理成本敏感的场景;
- 第二,建立 FP8/低精度训练的工程能力,这是未来降本的关键;
- 第三,与网络团队合作设计适合自己集群规模的拓扑,而不是直接套用 MPFT。
传统行业自建集群:
- 第一,不要轻易模仿 DeepSeek-V3 的全套方案,工程门槛过高;
- 第二,优先采用成熟的开源方案(如 Megatron-LM + NCCL + 标准 Fat-Tree),把 MLA/MoE 作为可选优化;
- 第三,如果预算有限,重点投资网络带宽而不是盲目追求模型规模。
结语:比具体协议更重要的,是工程哲学
DeepSeek-V3 的硬件反思不是终点,而是一个里程碑。它向行业证明了两件事:第一,即使在受管制的硬件上,通过激进的软件-模型协同设计,仍然可以榨出一流效率; 第二,任何技术方案的合理性都与它所在的组织语境强绑定。
国内同行学习 DeepSeek-V3,不是要照搬它的 MLA 参数、不是要照抄它的 Node-Limited Routing、不是要复刻它的 MPFT 拓扑——而是要学它 “针对自己的约束、自己的资源、自己的硬件边界,做最合身的设计” 这种工程哲学。
这个哲学,比任何具体机制都重要。
参考材料
- Chenggang Zhao et al., Insights into DeepSeek-V3: Scaling Challenges and Reflections on Hardware for AI Architectures, ISCA ’25 Industry Track. arXiv:2505.09343.
- DeepSeek-AI, DeepSeek-V3 Technical Report, arXiv:2412.19437.
- DeepSeek-AI, DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model, arXiv:2405.04434.
- DeepSeek-AI, DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models, arXiv:2401.06066.
- DeepSeek-AI, DeepEP: an efficient expert-parallel communication library, GitHub.
- DeepSeek-AI, DeepGEMM: clean and efficient FP8 GEMM kernels with fine-grained scaling, GitHub.
- Fabian Gloeckle et al., Better & Faster Large Language Models via Multi-token Prediction, ICML 2024.
- E. Agostini, D. Rossetti, S. Potluri, GPUDirect Async: Exploring GPU synchronous communication techniques for InfiniBand clusters, JPDC 2018.
- Karthik Mandakolathur, Sylvain Jeaugey, Doubling all2all Performance with NVIDIA Collective Communication Library 2.12, NVIDIA Blog, 2022.
- Adithya Gangidi et al., RDMA over Ethernet for Distributed AI Training at Meta Scale, SIGCOMM 2024.
- Qian et al., Alibaba HPN: A Data Center Network for Large Language Model Training, SIGCOMM 2024.
- Nils Blach et al., A High-Performance Design, Implementation, Deployment, and Evaluation of the Slim Fly Network, NSDI 2024.
术语表
MLA(Multi-head Latent Attention):DeepSeek 提出的注意力机制,通过低秩投影把多头 KV 压缩为共享潜在向量,显著降低推理时 KV Cache 内存占用。
DeepSeekMoE:DeepSeek 的稀疏专家混合架构,采用细粒度 routed expert 和共享 expert,每 token 只激活少量专家以控制计算量。
KV Cache:Transformer 推理时缓存历史 token 的 Key 和 Value,避免重复计算;是长上下文推理的主要内存瓶颈。
FP8(8-bit Floating Point):NVIDIA Hopper/Blackwell 支持的 8 位浮点格式,包含 E4M3 和 E5M2 两种变体,用于降低训练和推理的内存与计算开销。
LogFMT(Logarithmic Floating-Point Format):论文提出的对数浮点格式,把数值映射到对数空间以获得更均匀的分布,实验显示 8bit 精度优于传统 FP8。
DeepEP:DeepSeek 开源的专家并行通信库,针对 MoE 的 dispatch/combine all-to-all 模式优化,支持 IBGDA 等 GPU 直接触发机制。
DualPipe:DeepSeek 开源的双向流水线并行算法,通过重叠 attention/MoE 计算与通信来减少 pipeline bubble。
Node-Limited Routing:DeepSeek-V3 的路由约束策略,限制每个 token 最多访问固定数量的节点,利用 NVLink 转发减少 IB 流量。
Expert Parallelism(EP):把 MoE 的不同专家分布到不同 GPU 上,每个 token 通过网络被 dispatch 到目标专家计算后再 combine 回来。
Tensor Parallelism(TP):把模型层内参数切分到多张 GPU,需要高频 all-reduce,对节点内 NVLink 带宽敏感。
Pipeline Parallelism(PP):把模型按层切分到不同 GPU,通过流水线方式执行,需要处理 bubble 和负载均衡。
MPFT(Multi-Plane Fat-Tree):论文采用的多平面两层胖树网络拓扑,每个节点多张 NIC 分别属于独立平面,用两层网络支撑万卡规模。
MRFT(Multi-Rail Fat-Tree):单平面多轨道胖树,MPFT 是其子集;NCCL 的 PXN 机制可在 MRFT/MPFT 中通过 NVLink 优化跨平面流量。
Fat-Tree:数据中心网络常用拓扑,分为两层或三层 Clos 结构,提供非阻塞或低收敛比的 all-to-all 连接。
PXN(PCI × NVLink):NCCL 2.12 引入的优化机制,允许 GPU 通过 NVLink 把数据转发到同节点内与目标网络平面匹配的 GPU/NIC,减少跨平面流量。
IBGDA(InfiniBand GPUDirect Async):允许 GPU 直接填充 RDMA Work Request 并写 NIC doorbell 寄存器,绕过 CPU 代理以降低通信延迟。
RDMA(Remote Direct Memory Access):远程直接内存访问技术,允许一台机器直接读写另一台机器的内存,绕过 CPU 和操作系统内核。
RoCE(RDMA over Converged Ethernet):在以太网上实现 RDMA 的协议,成本低于 InfiniBand 但延迟和稳定性通常更差。
InfiniBand(IB):高性能计算领域常用的互连技术,提供低延迟、高带宽、无损网络的 RDMA 能力。
QP(Queue Pair):RDMA 中的通信端点抽象,包含发送队列和接收队列,是 RDMA 通信的基本单位。
ECMP(Equal-Cost Multi-Path):等价多路径路由,通过哈希把流量分散到多条路径,但在 LLM 训练大流场景下容易出现极化。
Adaptive Routing(AR):自适应路由,根据实时网络状态动态选择路径,通常通过 packet spraying 实现,能改善 ECMP 的负载不均问题。
MFU(Model FLOPs Utilization):模型浮点运算利用率,衡量实际训练吞吐与理论峰值算力的比值。
TPOT(Time Per Output Token):推理阶段每生成一个输出 token 的时间,是衡量解码延迟的关键指标。
NVLink / NVSwitch:NVIDIA 的 GPU 高速互联技术,NVLink 提供 GPU 间直接连接,NVSwitch 可在节点内或跨节点扩展 NVLink 网络。
PCIe:连接 CPU、GPU、NIC 等外设的高速串行总线,是多数服务器节点内 GPU-NIC-CPU 互联的基础。
H800:NVIDIA 面向中国市场推出的 Hopper 架构 GPU,计算性能和 NVLink 带宽相对 H100 有所降低,以满足出口管制要求。
HBM(High Bandwidth Memory):高带宽显存,用于 GPU 的高性能内存子系统,容量和带宽是 AI 训练的主要瓶颈之一。
Memory Wall(内存墙):处理器算力增长速度远超内存带宽和容量增长速度所导致的性能瓶颈。
全文终检清单
- 核心论点在 TL;DR、正文、结语出现 ≥3 次
- 高价值原图 100% 嵌入且每张有“三问式”解读段
- 自绘图 0 张,全文未调用图像生成模型
- 全部量化数据有出处、带单位、关键处加粗
- ≥2 张对比表(溯源表 + 决策归属表 + 成本/性能对比表)
- ≥3 处英文原文 blockquote 且每处有解读
- 每个“代价”论断挂具体机制与场景
- 事实/观点已做标注
- 术语表覆盖正文全部术语